
Son güncelleme: 1 Kasım 2026.
İlk bölümde şu cümleyi kurmuştuk: Google’da taranmıyor, dizine alınmıyor ve ilgili aramalarda bulunamıyorsanız AI Bakışı’nda kaynak olmanız da çok zor.
Bu bölüm o cümlenin açılımı. Yapay zekâ aramasını anlamak için bilmemiz gereken SEO temelini kısaca toparlayacağız: Arama motoru bir sayfayı nasıl buluyor, neden dizine alıyor ya da almıyor, hangi sayfayı neden öne çıkarıyor ve yapay zekâ bu zincirin neresine giriyor?
SEO’yu uzun süredir yapıyorsanız bu konuların çoğunu biliyorsunuz. Yine de okumanızı öneririm. Çünkü her başlığı “Bu yapay zekâ aramasında neyi değiştiriyor?” sorusuyla anlatacağım. Bazı eski bilgiler bu soruyla bambaşka bir önem kazanıyor.
1. Yapay zekâ interneti kendi başına okumuyor
Yapay zekâ aramasıyla ilgili en yaygın yanlış anlama şu: “ChatGPT interneti biliyor, Gemini her şeyi okuyor.”
Aslında cevap yazarken canlı bilgiye ihtiyaç duyan bir yapay zekâ da bir arama motoruna bağlı. Google’ın AI Bakışı ve AI Modu, cevaplarını Google’ın arama dizinindeki sayfalara dayandırıyor. ChatGPT’nin kendi arama tarayıcısı var. Microsoft Copilot, Bing’in dizinini kullanıyor.
Google bunu kendi belgesinde çok net söylüyor: Bir sayfanın AI Bakışı ya da AI Modu’nda kaynak olarak gösterilebilmesi için Google’da dizine alınmış olması ve arama sonuçlarında bir snippet ile gösterilmeye uygun olması gerekiyor. Bunun dışında ek bir teknik gereklilik yok (Google Search Central).
Bu cümle bence bu kitabın teknik tarafının özeti. Yapay zekâ için ayrı bir teknik SEO yok. Ama klasik teknik SEO’daki bir hatanın bedeli artık iki kez ödeniyor: hem arama sonuçlarında hem de yapay zekâ cevaplarında.
2. Arama motoru dört adımda çalışıyor, yapay zekâ beşinci adımı ekliyor
Bir sayfanın arama sonuçlarına ulaşması kabaca dört adımdan geçiyor:
- Keşif ve tarama (Crawl): Arama motoru sayfanın var olduğunu öğreniyor ve sayfayı ziyaret ediyor.
- Dizinleme (Index): Sayfayı okuyor, ne anlattığını anlıyor ve dizinine alıp almayacağına karar veriyor.
- Sıralama (Ranking): Bir arama yapıldığında dizindeki sayfalar arasından en uygun olanları seçip sıralıyor.
- Sunma (Serving): Sonuç sayfasında sayfayı bir başlık, açıklama ve gerekirse zengin sonuçlarla gösteriyor.
Yapay zekâ araması bu zincirin sonuna bir adım daha ekliyor: Getirme ve yazma. Yapay zekâ kullanıcının sorusunu sorgu yelpazesiyle alt aramalara bölüyor, bu aramaların sonuçlarından sayfalar getiriyor ve cevabı o sayfalardan yazıyor.
Buradaki kritik nokta şu: Beşinci adım, ilk dört adımın ürünü üzerinde çalışıyor. Taranmayan sayfa dizine girmez. Dizinde olmayan sayfa sıralanmaz. Sıralanmayan, yani hiçbir alt aramada bulunamayan sayfa yapay zekânın getirdiği kaynakların arasına giremez.
Her adımda sizin elinizde bir kontrol de var. Taramayı robots.txt ile, dizinlemeyi noindex ve canonical ile, sonuçlarda ne gösterileceğini nosnippet gibi etiketlerle yönetiyorsunuz. Bölümün geri kalanında bu adımları ve kontrolleri tek tek konuşacağız.
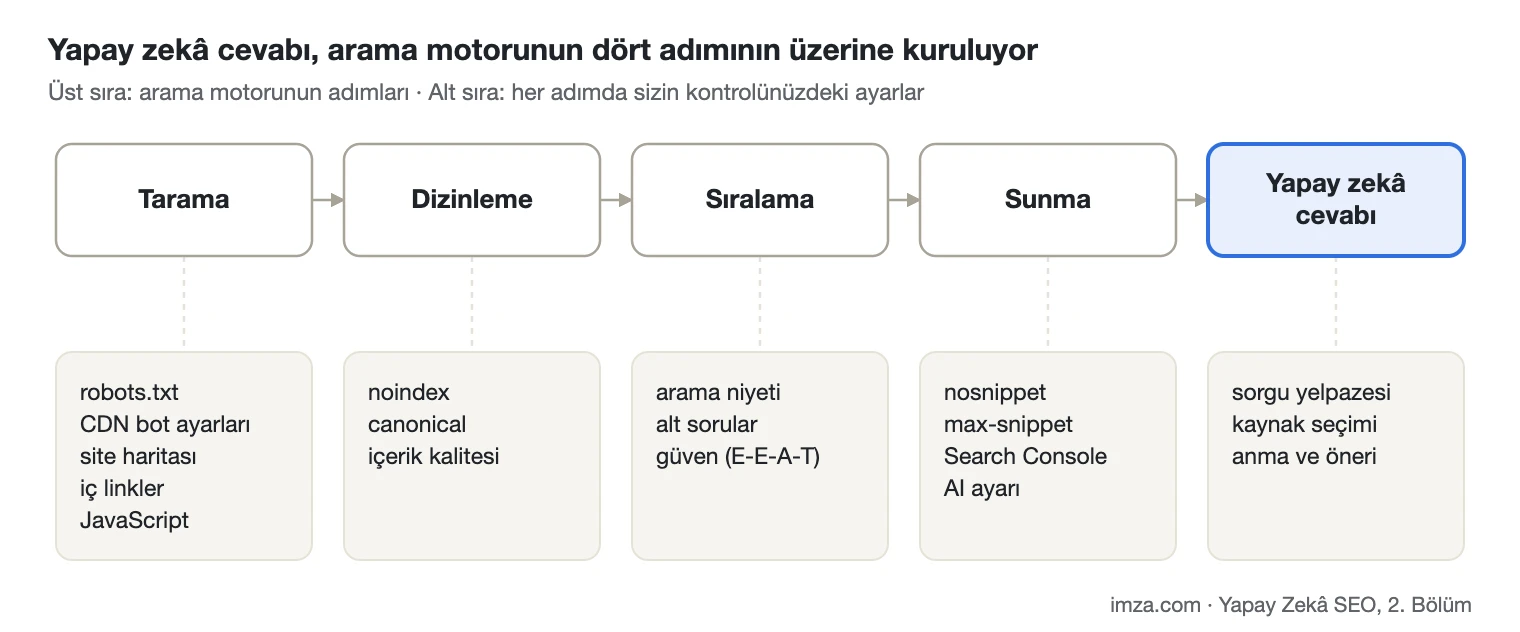
Üst sıradaki her adım bir öncekinin çıktısı üzerinde çalışıyor; alt sırada o adımı sizin yönettiğiniz ayarlar var.
3. Tarama: Google sayfanızı nasıl buluyor?
Google’ın yeni bir sayfadan haberdar olmasının iki ana yolu var: linkler ve site haritası (sitemap).
Yeni bir sayfa yayınladınız ve ana sayfadan, kategori sayfasından ya da başka bir yazıdan bu sayfaya link verdiniz. Googlebot bu linki takip ederek sayfayı keşfediyor. Hiçbir yerden link almayan sayfaların keşfedilmesi ise zorlaşıyor. Bunlara yetim sayfa (orphan page) diyoruz.
Site haritası ise Google’a “Bu adresler benim için önemli” dediğiniz dosya. Ama bir garanti değil. Site haritasına eklemek, Google’ın o sayfayı mutlaka tarayacağı ya da dizine alacağı anlamına gelmiyor. Güçlü bir keşif sinyali, o kadar.
Tarama tarafında küçük görünen bir ayarın ne kadar büyük etki yapabileceğini bir haber sitesinde yaşadık. Yeni haberler Google’a geç düşüyordu. Teknik tarafı incelerken site haritasının sunucu yükünü azaltmak için yaklaşık 10 dakika önbelleğe alındığını gördük. Haber saat 10.00’da yayınlanıyor, site haritasında 10.10 civarında görünüyordu. Önbellek süresini saniyelere indirdikten sonra gecikme büyük ölçüde ortadan kalktı.
Bu örneği yapay zekâ açısından düşündüğümüzde önemi daha da artıyor. Kullanıcı AI Modu’na güncel bir soru soruyor, yapay zekâ o anda dizinde ne varsa onunla cevap veriyor. Sayfanız henüz taranmadıysa, cevabı rakibinizin sayfasından yazıyor. Taranma hızı, güncel sorularda kaynak olup olmamanızı belirleyebiliyor.
Büyük sitelerde bir de tarama bütçesi (crawl budget) konusu var. Google bir siteye ayırdığı zamanı ve kaynağı sınırsız kullanmıyor. Milyonlarca filtre ve parametre adresi üreten bir e-ticaret sitesinde Googlebot zamanını değersiz adreslerde harcıyorsa, önemli sayfaların taranması gecikebiliyor. Google’ın yapay zekâ rehberi de büyük ve sık güncellenen siteleri özellikle tarama bütçesi rehberine yönlendiriyor (Google Search Central).
4. robots.txt: Neyi engellediğinizi bilin
robots.txt, sitenizin kök dizininde duran ve tarayıcılara “Şu bölümlere girebilirsin, şuralara girme” dediğiniz dosya.
Buradaki ilk kural şu: robots.txt taramayı kontrol eder, dizinlemeyi değil. Bir sayfayı robots.txt ile engellediğinizde Google sayfanın içeriğini okuyamıyor. Ama adresi başka yerlerden öğrendiyse, sayfa açıklamasız bir sonuç olarak yine görünebiliyor. Bir sayfanın arama sonuçlarında kesinlikle görünmemesini istiyorsanız doğru araç noindex. Onu da bir sonraki kısımda konuşacağız.
Yapay zekâ açısından ikinci kural daha önemli: Googlebot’u engellemek, AI Bakışı ve AI Modu’ndan da çıkmak demek. Google, yapay zekâ özelliklerinde tarama erişimini yönetmenin yolunun Googlebot kuralları olduğunu belirtiyor (Google Search Central). Google’ın arama için ayrı bir “yapay zekâ botu” yok.
Burada sık karıştırılan bir şey var: Google-Extended. Bu bir tarayıcı değil, robots.txt’de kullanılan bir kontrol etiketi. Google-Extended’ı engellediğinizde içeriğinizin Google’ın bazı diğer yapay zekâ sistemlerinde eğitim ve cevap dayanağı olarak kullanılmasını sınırlıyorsunuz. Ama Google Arama’yı etkilemiyor. Yani Google-Extended’ı engelleyerek AI Bakışı’ndan çıkamazsınız.
SEO’nun en klasik robots.txt hatalarından biri ise yapay zekâyla ilgili değil: Test ortamındaki “Disallow: /” satırının canlı siteye taşınması. Site yayına giriyor, her şey çalışıyor ama Google sitenin hiçbir sayfasını tarayamıyor. Yeni bir site ya da büyük bir güncellemeden sonra robots.txt’yi kontrol etmek bu yüzden ilk işlerden biri olmalı.
5. Her yapay zekâ botu aynı işi yapmıyor
Google’ın dışındaki yapay zekâ şirketleri ise farklı işler için farklı botlar kullanıyor. Kabaca üç tür bot var:
- Eğitim botları: İçeriği gelecekteki modellerin eğitiminde kullanılmak üzere topluyor.
- Arama botları: İçeriği yapay zekânın arama özelliğinde gösterebilmek için tarıyor ve dizine alıyor.
- Kullanıcı botları: Bir kullanıcı soru sorduğunda ya da bir link paylaştığında o anda sayfayı ziyaret ediyor.
En bilinenleri şunlar:
| Şirket | Eğitim | Arama | Kullanıcı isteği |
|---|---|---|---|
| Google-Extended (bot değil, kontrol etiketi) | Googlebot | Googlebot | |
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Microsoft | Bingbot |
Bu ayrım çok önemli, çünkü birini engellemek diğerini engellemek anlamına gelmiyor. OpenAI, robots.txt’de GPTBot’u engelleyip OAI-SearchBot’a izin verebileceğinizi, yani içeriğinizin eğitimde kullanılmasını istemeyip ChatGPT aramasında görünebileceğinizi açıkça yazıyor. Tersini yapar ve OAI-SearchBot’u engellerseniz, siteniz ChatGPT’nin arama cevaplarında kaynak olarak gösterilmiyor; en fazla gezinme linki olarak çıkabiliyor (OpenAI). Anthropic de üç botunu aynı mantıkla ayırıyor ve Claude-SearchBot’u engellemenin arama sonuçlarındaki görünürlüğü azaltabileceğini belirtiyor (Anthropic).
Bence çoğu site için mantıklı yaklaşım şu: Arama botlarına kapıyı açık tutun. Eğitim botları için kararı iş modelinize göre verin. Bir haber sitesi ya da içeriğinden para kazanan bir yayıncı eğitim botlarını engellemek isteyebilir. Bir üretici ya da e-ticaret sitesi ise genelde markasının yapay zekâ tarafından doğru tanınmasını ister.
Bir de dikkat edilmesi gereken bir nokta var: robots.txt tek kontrol noktası değil. Sunucu, güvenlik eklentisi ve CDN tarafındaki bot kuralları robots.txt’den önce devreye giriyor ve site sahibi çoğu zaman bunları fark etmiyor. Bunu bir sonraki maddede en yaygın örnek olan Cloudflare üzerinden açalım. Botları ve log analizini 9. bölümde detaylı konuşacağız.
6. Cloudflare: Botları siz değil, altyapınız engelliyor olabilir
robots.txt bir rica. Bot sitenize gelir, dosyayı okur ve kurala uyar ya da uymaz. Cloudflare gibi bir CDN ise isteği sunucunuza ulaşmadan karşılıyor. Yani robots.txt dosyanız “gel” dese bile CDN botu kapıda geri çevirebiliyor. Bot sayfanızı hiç göremiyor, siz de Search Console’da ya da analitik araçlarınızda bunun izini çoğu zaman göremiyorsunuz.
Cloudflare’e ayrı bir madde açmamın sebebi hem çok yaygın olması hem de son bir buçuk yılda yapay zekâ botlarıyla ilgili varsayılan ayarlarını birkaç kez değiştirmiş olması:
- Nisan 2025, yönetilen robots.txt: Cloudflare, yapay zekâ botlarına yönelik kuralları sizin robots.txt dosyanızın başına ekleyebiliyor. Yani WordPress’te ya da sunucuda gördüğünüz robots.txt ile tarayıcıda site.com/robots.txt adresinde gördüğünüz dosya aynı olmayabilir.
- Temmuz 2025, varsayılan engel: Cloudflare yeni eklenen alan adlarında yapay zekâ tarayıcılarını varsayılan olarak engellemeye başladı ve “Block AI bots” seçeneğini öne çıkardı. Kurulum sırasında hızlıca geçilen bir ekran, sitenin yapay zekâ botlarına kapanması demek olabiliyor.
- Temmuz 2026, üç kategori: Cloudflare botları artık tek bir “yapay zekâ botu” grubunda değil, işlevine göre üç grupta yönetiyor: Search (arama), Agent (kullanıcı adına sayfa açan yapay zekâ ajanları) ve Training (model eğitimi). 15 Eylül 2026’dan itibaren yeni alan adlarında, reklam gösteren sayfalarda Training ve Agent botları varsayılan olarak engelleniyor, Search botları açık kalıyor.
Son maddenin SEO açısından kritik bir detayı var. Cloudflare’in duyurusuna göre hem arama hem eğitim için kullanılan çok amaçlı botlar iki politikaya birden tabi. Training’i engellediğinizde Googlebot, Bingbot ve Applebot gibi botlar da, Search açık olsa bile engellenebiliyor. 4. maddede gördüğümüz gibi Googlebot’a kapanan bir site hem Google aramasından hem AI Bakışı’ndan çıkar. Yani “yapay zekâ içeriğimi eğitimde kullanmasın” diye verilen bir karar, fark edilmeden sitenin Google’dan düşmesine yol açabilir.
Agent kategorisi de ayrıca düşünülmeli. Bir kullanıcı ChatGPT’ye ya da Claude’a sizin sayfanızın linkini verip “bunu özetle” dediğinde sayfayı açan bot bu gruba giriyor. Bu botu engellerseniz, sizi zaten bulmuş olan bir kullanıcıya bile içeriğiniz okunamıyor.
Cloudflare kullanıyorsanız ya da müşterinizin sitesi Cloudflare arkasındaysa şunları kontrol edin:
- Bot ayarları: Cloudflare panelindeki güvenlik ve bot ayarlarına, varsa AI Crawl Control bölümüne bakın. Search, Agent ve Training için hangi kararın seçili olduğunu ve bunun bilinçli bir karar olup olmadığını netleştirin.
- Canlı robots.txt: Dosyayı sunucudan değil, tarayıcıda site.com/robots.txt adresinden okuyun. Sizin yazmadığınız satırlar varsa kaynağı büyük ihtimalle CDN’dir.
- Googlebot erişimi: Search Console’daki URL denetiminde canlı testi çalıştırın. Sayfa getirilemiyorsa ya da engellendi uyarısı varsa CDN kurallarına bakın. Aynı kontrolü Bing Webmaster Tools’ta da yapın.
- Engellenen istekler: Cloudflare’in güvenlik olayları ekranında hangi botların engellendiğini görebilirsiniz. Tarayıcıda kendi bot kimliğinizi taklit ederek yapılan testler yanıltıcı olabilir, çünkü Cloudflare doğrulanmış botları IP adresi ve imzayla tanıyor.
Bu konu sadece Cloudflare ile sınırlı değil. Diğer CDN’ler, hosting firewall’ları ve WordPress güvenlik eklentileri de benzer seçenekler sunuyor. Ortak kural şu: Yapay zekâ botları kararını robots.txt’de verip bıraktıysanız, aradaki her katmanın aynı kararı uyguladığını da kontrol edin.
7. JavaScript: Googlebot görüyor, diğerleri görmeyebilir
Modern sitelerin önemli bir kısmı içeriği tarayıcıda JavaScript ile oluşturuyor. Sayfanın ilk HTML’inde fiyat, ürün özellikleri ya da yorumlar yok; sayfa açıldıktan sonra JavaScript bunları ekliyor.
Google bu sayfaları işleyebiliyor. Googlebot JavaScript’i çalıştırıyor ve sayfayı bir tarayıcı gibi oluşturuyor. Google’ın rehberi de JavaScript engellenmediği sürece bu içeriği işleyebildiğini, ama JavaScript tabanlı sitelerin optimizasyonunun genelde daha karmaşık olduğunu belirtiyor (Google Search Central).
Diğer yapay zekâ botları için durum farklı olabilir. Vercel, 2024 sonunda kendi ağındaki bot trafiğini incelediğinde GPTBot, ClaudeBot ve PerplexityBot’un JavaScript çalıştırmadığını gördü. Bu botlar JavaScript dosyalarını indiriyor ama çalıştırmıyordu. JavaScript’i işleyenler, Googlebot altyapısını kullanan Gemini ve AppleBot’tu (Vercel). Bu tablo zamanla değişebilir ama bugün için güvenli varsayım şu:
Önemli bilgileriniz sayfanın ilk HTML’inde olmalı. Fiyat, stok, teknik özellikler, ürün açıklaması, iletişim bilgileri ve sık sorulan soruların cevabı JavaScript çalışmadan da okunabilmeli. Aksi halde Google sizi doğru anlarken ChatGPT ya da Claude boş bir sayfa görebilir.
Bunu kontrol etmenin en basit yolu tarayıcıda sayfaya sağ tıklayıp “Sayfa kaynağını görüntüle” demek ve önemli bilgileri orada aramak. Orada göremediğiniz bilgiyi JavaScript çalıştırmayan bir bot da göremiyor. Next.js, Nuxt gibi çerçeveler kullanıyorsanız sunucu tarafında oluşturma (server-side rendering) ya da önceden oluşturma (pre-rendering) bu problemi çözüyor.
8. Dizinleme: Google taramadığını da, tarayıp beğenmediğini de dizine almaz
Tarama ile dizinleme aynı şey değil. Google bir sayfayı tarayıp okuyabilir ve yine de dizinine almayabilir.
Bunun birkaç yaygın sebebi var: Sayfa başka bir sayfanın kopyası ya da çok benzeri olabilir. İçerik çok zayıf olabilir. Sayfada noindex etiketi olabilir. Ya da Google o sayfayı dizine almaya değer bulmamış olabilir. Search Console’daki “Taranmış, şu anda dizine eklenmemiş” uyarısı çoğu zaman bu son durumu anlatıyor.
Yapay zekâ açısından sonuç basit: Dizinde olmayan bir sayfa, ne kadar iyi olursa olsun, AI Bakışı’nda kaynak olamaz. Ürününüzü en iyi anlatan sayfa dizinde değilse, yapay zekâ sizi başka bir sayfadan, belki bir ilan sitesinden ya da rakibinizin karşılaştırma yazısından öğreniyor.
Dizinleme tarafında daha fazla sayfa her zaman daha iyi değil. Filmler.com’da yaklaşık 450.000 oyuncu ve ekip kaydı vardı. Hepsini dizine açmak yerine içerik girilmiş, yeterli değeri olan sayfaları dizine açtık. Gereksiz sayfalar dizini şişiriyor, tarama bütçesini harcıyor ve sitenin genel kalitesine dair yanlış bir izlenim bırakabiliyor.
Yapay zekâ aramasında bu kararın bir boyutu daha var: Dizine açtığınız her sayfa, yapay zekânın markanız hakkında okuyabileceği bir kaynak. Boş ya da eski bilgi içeren sayfalar, markanızın yanlış anlatılmasına da sebep olabiliyor.
9. noindex ve canonical: Hangi sayfanın görüneceğini siz söyleyin
Bir sayfanın arama sonuçlarında görünmesini istemiyorsanız kullanacağınız araç Dizine Almama (noindex) etiketi. Googlebot sayfayı tarayıp bu etiketi gördüğünde sayfayı sonuçlardan çıkarıyor. Noindex aldığınız sayfa, doğal olarak yapay zekâ özelliklerinde de kaynak olamıyor.
Burada bilinmesi gereken küçük ama kritik bir detay var: Google’ın noindex etiketini görebilmesi için sayfayı tarayabilmesi gerekiyor. Bir sayfayı hem robots.txt ile engelleyip hem noindex verirseniz, Google sayfaya giremediği için noindex’i de göremeyebilir.
Standart URL (Canonical) ise aynı ya da çok benzer içeriğe sahip birden fazla adres olduğunda, Google’a hangisinin asıl adres olduğunu söylediğiniz etiket. Bir ürünün renk filtresiyle açılan beş farklı adresi varsa, canonical ile güç tek bir adreste topluyorsunuz.
Canonical bir talimat değil, bir sinyal. Google başka sinyallere bakarak farklı bir sayfayı asıl adres seçebiliyor. Search Console’daki URL denetimi aracı Google’ın hangi adresi seçtiğini gösteriyor. Yapay zekâ cevabında sizin istediğiniz sayfa yerine eski ya da filtreli bir adresin kaynak gösterildiğini görüyorsanız, ilk bakacağınız yerlerden biri burası.
10. Snippet kontrolleri ve Search Console’daki yeni ayar
Google’ın AI özellikleri için koyduğu ikinci şartı hatırlayalım: Sayfanın bir snippet ile gösterilmeye uygun olması.
Snippet, arama sonucunda başlığın altında görünen açıklama metni. Site sahipleri bunu yıllardır bazı etiketlerle kontrol edebiliyor:
- nosnippet: Sayfadan hiçbir metin önizlemesi gösterilmesin.
- max-snippet: Önizleme en fazla şu kadar karakter olsun.
- data-nosnippet: Sayfanın sadece belirli bir bölümü önizlemede kullanılmasın.
Google, AI Bakışı ve AI Modu’nda sayfanızdan ne gösterileceğini sınırlamak için de aynı etiketlerin kullanılabileceğini söylüyor (Google Search Central). Yani bu etiketleri bilinçsiz kullanırsanız yapay zekâ cevaplarından da çıkabilirsiniz. Bazı SEO eklentilerinde ya da temalarda bu etiketlerin varsayılan olarak açık gelebildiğini unutmamak gerekiyor; sayfa kaynağında “robots” meta etiketine bir kez bakmak yeterli.
Bir de yeni bir ayar var. Google Haziran 2026’da Search Console’a, sitenizin yapay zekâ özelliklerinde görünüp görünmeyeceğini seçebildiğiniz bir kontrol eklemeye başladı. 31 Ağustos 2026 itibarıyla bütün sitelere açıldı (Google). Bu ayarla AI Bakışı, AI Modu ve Discover’daki AI Bakışı’ndan çıkabiliyorsunuz. Google, bu ayarın normal arama sonuçlarında bir sıralama sinyali olarak kullanılmayacağını, ama çıkan sitelerin bu özelliklerden trafik ve gösterim almayacağını belirtiyor.
Bence çoğu işletme için bu ayarın açık kalması mantıklı. 1. bölümde gördüğümüz gibi yapay zekâdan gelen ziyaretçi az ama değerli. Yine de içeriğinden doğrudan para kazanan yayıncılar için bu, üzerinde düşünülmesi gereken bir karar. Önemli olan, ayarın ne durumda olduğunu bilmek ve bilinçli karar vermek.
11. Sıralama: Doğru soruya cevap veren sayfa
Dizindeki milyarlarca sayfa arasından hangisinin öne çıkacağını yüzlerce sinyal belirliyor. Ama bence sıralamanın merkezinde hep aynı soru var: Bu sayfa kullanıcının sorusuna gerçekten cevap veriyor mu?
Bunun için önce sorunun arkasındaki niyeti anlamak gerekiyor. Arama Niyeti (Search Intent) genelde dört grupta anlatılıyor:
- Bilgi: Kullanıcı bir şey öğrenmek istiyor. “Dolum makinesi nasıl çalışır?”
- Araştırma ve karşılaştırma: Seçenekleri tartıyor. “Pistonlu mu dalgıç nozullu mu?”
- İşlem: Satın almak ya da teklif istemek istiyor. “Dolum makinesi fiyat teklifi”
- Gezinme: Belirli bir siteye ulaşmak istiyor. “X makine iletişim”
Kullanıcı bilgi arıyorsa ürün sayfanız, satın almaya hazırsa blog yazınız doğru cevap olmayabilir. Çok iyi bir içerik yazmış olabilirsiniz ama yanlış soruya cevap veriyorsanız sıralanmak zor.
Yapay zekâ araması bu konuyu daha da önemli hale getiriyor. Sorgu yelpazesi kullanıcının tek sorusunu birden fazla alt aramaya bölüyor ve her alt aramanın kendi niyeti var. “Köpüren ürün için hangi dolum makinesi?” sorusu arka planda hem bilgi (“köpüren sıvı nasıl doldurulur”), hem karşılaştırma (“dolum makinesi türleri”), hem de işlem (“dolum makinesi üreticileri”) aramalarına dönüşebiliyor. 1. bölümde konuştuğumuz gibi kaynak gösterilen sayfaların önemli bir kısmı bu alt aramalardan geliyor.
Bu yüzden sitenizde sadece ana kelimeye değil, kullanıcının karar verirken soracağı alt sorulara da net cevap veren sayfalar olması gerekiyor. Bunu her alt soru için ayrı sayfa açarak değil, sayfalarınızı gerçekten eksiksiz hale getirerek yapıyoruz.
12. Güven: Google kime, yapay zekâ kime inanıyor?
Google içeriğin kalitesini anlatırken yıllardır dört kavram kullanıyor: Deneyim (Experience), Uzmanlık (Expertise), Otorite (Authoritativeness) ve Güvenilirlik (Trustworthiness). Kısaca E-E-A-T.
Bunlar tek başına bir sıralama faktörü değil, Google’ın kaliteli içeriği tarif etme biçimi. İçeriği kim yazmış, o kişinin konuyla gerçek bir deneyimi var mı, site bu konuda tanınıyor mu, bilgiler doğru ve güncel mi?
Yapay zekâ aramasında bu soruların ağırlığı artıyor. Çünkü yapay zekâ bir cevabı kendi cümleleriyle yazıyor ve yanlış bir kaynağa dayanırsa yanlışı da kendi ağzından söylemiş oluyor. Google’ın yapay zekâ rehberi de özellikle sıradan olmayan, özgün bir bakış açısı ve birinci elden deneyim içeren içeriğin önemine vurgu yapıyor (Google Search Central).
Pratikte bunun anlamı şu: Kimin yazdığı belli olan, yazarın uzmanlığını gösteren, iddialarını kaynakla destekleyen, güncelleme tarihi olan ve şirketin gerçekten var olduğunu gösteren bilgileri (adres, iletişim, referanslar) açıkça sunan sayfalar. Bu konuyu 12. ve 13. bölümlerde, kopyalanamayan içerik ve marka tarafında detaylı konuşacağız.
13. Sayfa deneyimi: Site açılmıyorsa gerisi önemsiz
Google’ın rehberi kullanıcıya iyi bir deneyim sunmayı da temel şartlar arasında sayıyor: Farklı cihazlarda düzgün görünen, hızlı açılan ve asıl içeriğin sayfadaki diğer unsurlardan kolayca ayrılabildiği sayfalar.
Son madde yapay zekâ açısından özellikle önemli. Menüler, açılır pencereler, çerez bildirimleri ve reklamlar arasında kaybolan bir içeriği hem kullanıcı hem bot zor okuyor. Başlıkları doğru sırada kullanan, ana içeriği net bir şekilde ayıran anlamlı bir HTML yapısı Google’ın da önerdiği bir şey; zorunlu değil ama iyi bir alışkanlık.
Bir de en temel konu var: Sitenin açık olması. Bir müşterimizde site yaklaşık bir saat kapalı kalmıştı. Bu yüzden çalışmaya başladığımız her müşteride sitenin açık olup olmadığını anlık izleyen araçlar kullanıyoruz. Tarayıcı geldiğinde site cevap vermiyorsa, ne sıralama ne de yapay zekâ cevabı konuşabiliyoruz. Kullanıcı bir soruyu soruyor ve yapay zekâ o anda sitenize ulaşamıyorsa, cevabı başka bir kaynaktan yazıyor.
14. Yapılandırılmış veri: Gerekli değil, faydalı
Yapılandırılmış veri (Schema), sayfadaki bilgileri makinelerin kolay okuyabileceği bir formatta işaretlemek demek. Ürünün adı, fiyatı, stok durumu, yorum puanı, şirketin adresi gibi.
Yapay zekâ aramasıyla birlikte “AI için özel Schema” gibi öneriler sık dolaşmaya başladı. Google bu konuda net: AI özellikleri için eklemeniz gereken özel bir Schema işaretlemesi yok. Ama yapılandırılmış veriyi kullanmaya devam etmeyi öneriyor, çünkü zengin sonuçlar için hâlâ gerekli (Google Search Central).
Benim bakışım şu: Yapılandırılmış veri sizi yapay zekâ cevabına tek başına sokmaz. Ama fiyat, stok, adres, çalışma saatleri gibi ticari bilgilerinizin doğru ve tutarlı okunmasına yardım eder. Bu bilgilerin yanlış anlatılması da 1. bölümde konuştuğumuz en tehlikeli durumdu. 10. ve 15. bölümlerde bu konuya geri döneceğiz.
15. Google tek arama motoru değil: Bing ve Copilot
Türkiye’de SEO denince akla neredeyse sadece Google geliyor ve trafik açısından bunun bir sebebi var. Ama yapay zekâ aramasında Bing’in önemi payından daha büyük.
Microsoft Copilot cevaplarını Bing’in dizinine dayandırıyor. ChatGPT arama ilk çıktığında da Bing’in verilerinden önemli ölçüde yararlanıyordu (Yoast); bugün OpenAI’ın kendi arama botu da var. Yani Bing’de dizinde olmayan bir sayfa, bazı yapay zekâ cevaplarında da görünmeyebilir.
Bu yüzden Bing Webmaster Tools’a sitenizi eklemek, site haritanızı göndermek ve Bing’in dizinleme durumunu kontrol etmek artık “olsa iyi olur” değil. Bing’in yeni içerikleri hızlıca bildirmek için desteklediği IndexNow protokolü de bu işi kolaylaştırıyor; birçok SEO eklentisi bunu tek ayarla yapabiliyor.
Bing’in bir avantajı da ölçüm tarafında. Bing Webmaster Tools 2026’nın başında, sayfalarınızın Copilot ve Bing’in yapay zekâ cevaplarında kaç kez kaynak gösterildiğini, hangi sayfaların kaynak olarak kullanıldığını ve yapay zekânın sizi hangi aramalarla bulduğunu gösteren bir yapay zekâ performans raporu yayınladı (Koozai). Rapor henüz önizleme aşamasında ve tıklama verisi içermiyor ama yapay zekâ görünürlüğünü bir arama motorunun kendi verisiyle görebildiğimiz ilk raporlardan biri.
16. Temeli nasıl ölçeceğiz?
Teknik temelin sağlam olup olmadığını anlamak için pahalı araçlara ihtiyaç yok. Üç ücretsiz kaynak işin büyük kısmını görüyor:
- Google Search Console: Dizinleme raporu hangi sayfaların dizinde olup olmadığını, URL denetimi Google’ın bir sayfayı nasıl gördüğünü gösteriyor. AI Bakışı ve AI Modu’ndaki görünürlük performans raporunda “Web” arama türünün içinde sayılıyor (Google Search Central). Google ayrıca hangi sayfalarınızın yapay zekâ cevaplarında hangi ülkelerde göründüğünü gösteren yeni bilgileri de Search Console’a eklemeye başladı.
- Bing Webmaster Tools: Bing dizini ve Copilot’taki kaynak gösterilme verisi.
- Sunucu logları: Hangi botun sitenize ne sıklıkla geldiğini, hangi sayfaları tarayıp hangilerine hiç uğramadığını gösteren tek gerçek kaynak. Bunu 9. bölümde detaylı konuşacağız.
Yapay zekâ görünürlüğünün kendisini, yani hangi sorularda anıldığınızı, önerildiğinizi ve kaynak gösterildiğinizi ölçmek ise ayrı bir iş. Bu da 7. bölümün konusu.
17. Bu bölümden aklınızda kalması gereken
Yapay zekâ araması SEO’nun temelini değiştirmedi, ama temeldeki her boşluğun bedelini artırdı.
Eskiden yanlışlıkla noindex alan bir sayfa sadece arama sonuçlarından düşüyordu. Bugün aynı sayfa yapay zekânın markanızı öğrendiği kaynaklardan da düşüyor ve yerini başkasının sayfası alıyor. JavaScript ile yüklenen bir fiyat eskiden sadece biraz gecikmeyle dizine giriyordu. Bugün bazı yapay zekâ botları o fiyatı hiç görmeyebiliyor. CDN’de tek tıkla açılan bir bot ayarı da robots.txt’nize hiç bakmadan botları kapıdan çevirebiliyor.
Bu yüzden kitabın geri kalanında konuşacağımız prompt araştırması, içerik stratejisi ya da marka çalışmasına geçmeden önce aşağıdaki listeyi bir kez kontrol etmenizi öneririm. Temel sağlam değilse üzerine kuracağınız her şey zayıf kalır.
Temel kontrol listesi
| Kontrol | Nasıl bakılır? | Neden önemli? |
|---|---|---|
| robots.txt Googlebot’u ve arama botlarını engellemiyor | site.com/robots.txt | Googlebot engeliyse AI Bakışı’ndan da çıkarsınız |
| Eğitim ve arama botları için bilinçli bir karar var | robots.txt, CDN ve güvenlik eklentisi ayarları | OAI-SearchBot ya da Claude-SearchBot engeli o platformun aramasından çıkarır |
| Cloudflare/CDN bot ayarları robots.txt kararıyla aynı | CDN paneli (Cloudflare’de AI Crawl Control), canlı robots.txt, URL denetimi canlı testi | CDN engeli robots.txt’yi boşa çıkarır; Training engeli Googlebot’u bile etkileyebilir |
| Önemli sayfalar dizinde | Search Console dizinleme raporu, URL denetimi | Dizinde olmayan sayfa kaynak olamaz |
| Önemli sayfalarda yanlışlıkla noindex yok | Sayfa kaynağında “robots” meta etiketi | Noindex sayfayı hem aramadan hem yapay zekâdan çıkarır |
| nosnippet ya da çok düşük max-snippet yok | Sayfa kaynağı, SEO eklentisi ayarları | Snippet uygunluğu AI özelliklerinin şartı |
| Search Console’daki yapay zekâ ayarı bilinçli seçilmiş | Search Console ayarları | Kapalıysa AI özelliklerinden trafik gelmez |
| Canonical’lar doğru adresi gösteriyor | URL denetimi, “Google’ın seçtiği standart URL” | Yanlış adres kaynak gösterilebilir |
| Fiyat, özellik ve iletişim bilgisi ilk HTML’de | Sayfa kaynağını görüntüle | Bazı botlar JavaScript çalıştırmıyor |
| Site haritası güncel ve hızlı güncelleniyor | Search Console site haritaları raporu | Güncel sorularda taranma hızı belirleyici |
| Site Bing’de de dizinde | Bing Webmaster Tools | Copilot ve bazı yapay zekâ cevapları Bing’e dayanıyor |
| Site açıklığı anlık izleniyor | Uptime izleme aracı | Ulaşılamayan site hiçbir yerde kaynak olamaz |
Kaynaklar
- Google Search Central: AI features and your website (son güncelleme 10 Aralık 2025)
- Google Search Central: Optimizing for generative AI search (son güncelleme 10 Temmuz 2026)
- Google: New opportunities, control and insights for website owners (3 Haziran 2026, güncelleme 31 Ağustos 2026)
- OpenAI: Overview of OpenAI crawlers
- Anthropic: Does Anthropic crawl data from the web?
- Vercel: The rise of the AI crawler (17 Aralık 2024)
- Yoast: What is ChatGPT Search (and how does it use Bing data)? (12 Kasım 2024)
- Koozai: Bing Webmaster Tools launches AI Performance reporting (13 Şubat 2026)
- Cloudflare Bots changelog (yönetilen robots.txt, Nisan ve Temmuz 2025; Search/Agent/Training seçenekleri, 1 Temmuz 2026)
- Help Net Security: Cloudflare changes AI crawler access rules (2 Temmuz 2026)
- Decrypt: Cloudflare hits kill switch on AI crawlers (Temmuz 2025)
Önceki: 1. Bölüm, Arama Nasıl Değişti? · Kitabın dizini · Sonraki: 3. Bölüm, Yapay Zekâ Bir Cevabı Nasıl Oluşturuyor?