
Son güncelleme: 1 Kasım 2026.
Önceki bölümde Google’ın bir sayfayı nasıl keşfettiğini, yani Tarama (Crawl) sürecini konuşmuştuk.
Bu bölümün kavramı: Dizinleme (Index)
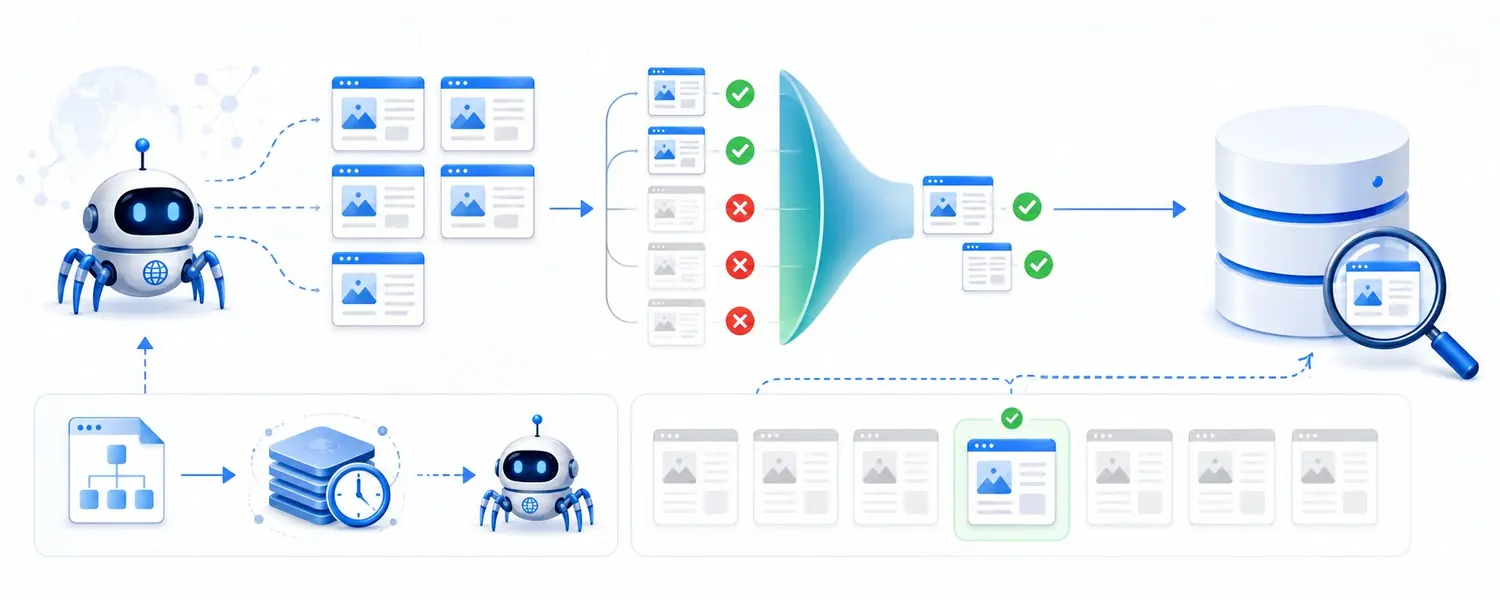
Googlebot’un bir sayfayı taramış olması, o sayfanın Google’da mutlaka görüneceği anlamına gelmiyor. Tarama sonrasında Google sayfanın içeriğini anlamaya çalışıyor. Sayfadaki şu unsurları değerlendiriyor:
- Metinleri
- Başlıkları
- Görselleri
- Linkleri
- Sayfanın genel konusunu
Eğer sayfayı arama sonuçlarında göstermeye değer bulursa Google’ın dizinine ekleyebiliyor. Bu işleme index, yani dizinleme diyoruz.
En basit haliyle:
- Tarama (Crawl): Google sayfayı buldu ve ziyaret etti.
- Dizinleme (Index): Google sayfayı dizinine aldı.
Burada önemli bir nokta var:
Google taradığı her sayfayı indexlemek zorunda değil.
Hatta bugün birçok internet sitesinde gördüğümüz en önemli SEO problemlerinden biri, sayfaların hiç indexlenmemesi veya çok geç indexlenmesi. Bir içerik yayınlıyorsunuz ama Google bunu saatler, günler hatta bazen daha uzun süre arama sonuçlarına dahil etmeyebiliyor. Dolayısıyla iyi içerik hazırlamak tek başına yeterli değil.
Google’ın o içeriği keşfetmesi, taraması ve indexlemeye değer bulması gerekiyor.
Google da bunu açıkça söylüyor: Sayfanız Google’ın temel kurallarına (Search Essentials) uysa bile Google onu tarayacağını, dizine ekleyeceğini ya da sonuçlarda göstereceğini garanti etmiyor (Google).
Dizinleme sırasında Google ne yapıyor?
Google’ın aynı sayfada anlattığına göre süreç kabaca şöyle işliyor:
- Tarama sırasında sayfayı işliyor (render) ve sayfadaki JavaScript’i çalıştırıyor. Böylece sayfayı bir tarayıcının gösterdiğine yakın şekilde görüyor.
- İnternette bulduğu birbirine benzeyen sayfaları bir grupta topluyor (clustering) ve bu grubu en iyi temsil eden sayfayı asıl sayfa (canonical) olarak seçiyor.
- Sayfanın dili, içeriğin hangi ülkeye yönelik olduğu ve sayfanın kullanılabilirliği gibi sinyalleri topluyor.
Google, işlediği her sayfanın dizine eklenmeyeceğini de ayrıca belirtiyor. Sık görülen nedenler arasında içeriğin düşük kalitede olması, robots meta etiketinin dizine eklemeye izin vermemesi ve sitenin tasarımının dizine eklemeyi zorlaştırması var.
İkinci madde, aşağıda anlattığım “Bende zaten bunun bir benzeri var.” durumunun Google tarafındaki karşılığı.
Bir sayfa neden dizine girmez?
Bir sayfanın indexlenmemesinin birçok sebebi olabilir:
- Sayfada noindex etiketi olabilir.
- Canonical başka bir URL’yi işaret ediyor olabilir.
- Teknik bir problem nedeniyle Google sayfaya düzgün erişemiyor olabilir.
- İçerik çok zayıf olabilir.
- Sayfa yeni olabilir ve Google henüz işlememiş olabilir.
Bu nedenleri kabaca beş grupta toplayabiliriz:
| Neden | Ne oluyor? | Nereden anlarız? |
|---|---|---|
| Kalite | İçerik zayıf ya da Google’ın zaten bildiği sayfalara bir şey eklemiyor. | Search Console’da “Tarandı: Şu anda dizine eklenmiş değil” |
| Kopya / canonical | Sayfa başka bir sayfanın kopyası ya da benzeri sayılıyor, Google başka bir URL’yi esas alıyor. | “Doğru standart etikete sahip alternatif sayfa”, “Kopya, Google kullanıcıdan farklı bir standart sayfa seçti” |
| noindex | Sayfada Google’a “Bu sayfayı dizine ekleme” diyen bir etiket var. | “URL ‘noindex’ olarak işaretlenmiş” |
| Teknik hata | Sayfa 404 veriyor, sunucu hata dönüyor ya da yönlendirme bozuk. | “Bulunamadı (404)”, “Sunucu hatası (5xx)”, “Yönlendirme hatası” |
| Tarama sorunu | Google sayfaya ulaşamıyor ya da URL’yi bilmesine rağmen henüz taramamış. | “URL, robots.txt tarafından engellendi”, “Bulundu: Şu anda dizine eklenmiş değil” |
Bir de bence özellikle üzerinde durulması gereken konu şu:
Sayfanızın çok benzerini Google daha önce indexlediyse yeni sayfayı ayrıca indexlemeyebilir.
Örneğin aynı konuyu anlatan 10 farklı sayfanız olduğunu düşünelim. Kelimeler biraz değişmiş olsa bile bu sayfalar temelde aynı ihtiyaca cevap veriyorsa Google bunları birbirinin benzeri olarak değerlendirebilir. Bu durumda Google “Bende zaten bunun bir benzeri var.” deyip URL’lerden birini esas alabilir, diğerlerini ayrıca indexlemeyebilir.
Özellikle şunlar bu açıdan dikkat edilmesi gereken örnekler:
- Birbirine çok benzeyen ürün sayfaları
- Filtre ve parametre URL’leri
- Aynı konuyu tekrar tekrar anlatan içerikler
- Şehir/ilçe adı değiştirilerek oluşturulan benzer sayfalar
- Çok az farklılaşan kategori sayfaları
Yani soru sadece “Bu sayfa kaliteli mi?” değil. Bir de “Bu sayfa Google’ın zaten bildiği sayfalardan farklı olarak ne sunuyor?” diye düşünmek gerekiyor.
noindex ve canonical’a kısa bir giriş
Yukarıdaki tabloda iki kavram sık geçiyor. İkisi de dizinlemeyi doğrudan etkilediği için kısaca anlatmak istiyorum.
noindex, sayfanın kodunda Google’a “Bu sayfayı tarayabilirsin ama dizine ekleme” diyen bir talimat. Genellikle sayfanın <head> bölümüne şöyle yazılıyor:
<meta name="robots" content="noindex">Teşekkür sayfaları, site içi arama sonuçları ya da test sayfaları gibi Google’da çıkmasını istemediğimiz sayfalarda işe yarıyor. Sorun, bu etiketin yanlışlıkla önemli sayfalarda kalması. Bir de şunu bilmek gerekiyor: Google noindex etiketini ancak sayfayı tarayabildiğinde görebiliyor. Sayfa robots.txt ile engelliyse Google etiketi okuyamıyor (Google).
Canonical, birbirine çok benzeyen sayfalar arasında hangisinin asıl sayfa olduğunu Google’a söylediğimiz etiket. Kahve makinesi kategorisini düşünelim. Renk filtresi seçildiğinde adres site.com/kahve-makinesi?renk=siyah oluyor ama sayfanın büyük bölümü aynı. Bu filtre sayfasına şöyle bir etiket koyarak asıl sayfanın kategori olduğunu belirtebiliyoruz:
<link rel="canonical" href="https://site.com/kahve-makinesi/">Burada önemli bir ayrıntı var: canonical bir talimat değil, güçlü bir sinyal. Google başka sinyallere bakıp farklı bir URL’yi asıl sayfa olarak seçebiliyor (Google). noindex’i ve robots.txt ile farkını 23. bölümde, canonical’ı ve dizin şişmesini 25. bölümde ayrıntılı anlatıyorum.
Sayfa dizinde mi, nasıl kontrol ederiz?
Peki bir sayfanın indexlenip indexlenmediğini nasıl kontrol ederiz? En sağlıklı yöntem Google Search Console’daki URL Denetleme (URL Inspection) aracı.
Ama hızlıca Google üzerinden de kontrol edebilirsiniz. Örneğin indir.com içerisinde WinRAR ile ilgili indexlenmiş sayfaları görmek için şunu aratabilirsiniz:
site:indir.com winrarveya doğrudan URL’nin bir bölümünü aratabilirsiniz. Bu yöntem hızlı bir kontrol sağlar ama kesin sonuç için Search Console’u kullanmak daha doğru. site: ve diğer arama operatörlerini 7. bölümde anlatıyorum.
Search Console’da zaman zaman Tarandı: Şu anda dizine eklenmiş değil (Crawled – currently not indexed) veya Bulundu: Şu anda dizine eklenmiş değil (Discovered – currently not indexed) ifadelerini görebilirsiniz.
İkisi birbirine benziyor ama aynı şey değil:
- Bulundu (Discovered): Google URL’yi biliyor ama henüz taramamış.
- Tarandı (Crawled): Google sayfayı taramış ama şu anda indexlememiş.
Search Console’da Sayfa dizine ekleme (Page indexing) raporu
URL Denetleme tek bir sayfaya bakmak için iyi. Sitenin geneline bakmak için ise Search Console’daki Sayfa dizine ekleme (Page indexing) raporunu kullanıyoruz. Bu rapor sitenizdeki URL’leri iki gruba ayırıyor: Dizine eklendi (Indexed) ve Dizine eklenmedi (Not indexed). Dizine eklenmeyen URL’lerin altında da her birinin nedeni ayrı ayrı listeleniyor (Search Console Yardım).
Bu raporu ilk açtığınızda “Dizine eklenmedi” sayısının yüksek olması sizi korkutmasın. Google da sitedeki bütün URL’lerin dizine eklenmesini beklemememiz gerektiğini söylüyor. Filtre sayfaları, yönlendirmeler, canonical verdiğimiz kopyalar, noindex koyduğumuz sayfalar zaten bu listede olmalı. Hedef her URL’nin değil, önemli sayfaların asıl (canonical) halinin dizinde olması.
Ben bu raporu okurken şu sırayla ilerlemeyi faydalı buluyorum:
- Önce nedenlerin listesine bakıp hangisinde kaç URL olduğunu görmek.
- Her nedenin içine girip örnek URL’leri incelemek. Orada önemli bir ürün, kategori veya içerik sayfası var mı?
- Önemli bir sayfa yanlışlıkla noindex, 404 ya da yönlendirme yüzünden listedeyse önce onu düzeltmek.
- “Tarandı: Şu anda dizine eklenmiş değil” listesindeki önemli sayfalarda içeriğin gerçekten farklı ve yeterli olup olmadığını sorgulamak.
- Düzeltme yaptıktan sonra URL Denetleme’den sayfanın dizine eklenmesini istemek.
Search Console’u bütün raporlarıyla 29. bölümde anlatıyorum.
Geç indexlenme: bir haber sitesi örneği
Geç indexlenme konusunda yaşadığımız ilginç bir örnek de var. Türkiye’nin büyük haber sitelerinden biri olan müşterimizin ciddi bir geç indexlenme problemi vardı. Haber sitesi olduğu için burada dakikaların bile önemi var.
Problemin nedenini uzun süre beklemediğimiz bir yerde aradık ve sonunda oldukça ilginç bir detay bulduk. Yazılımcılar sunucuya fazla yük binmesin diye sitemap’e 10 dakikalık cache koymuşlar.
Yani siteye yeni bir haber girildiğinde sayfa yayındaydı ama sitemap Google’a güncel halini hemen göstermiyordu. Saniyede bir içerik bile girseniz, Google yeni URL’leri sitemap üzerinden en erken cache yenilendiğinde görebiliyordu.
Cache süresini dakikalardan saniyeler seviyesine indirdiğimizde geç indexlenme problemi büyük ölçüde çözüldü. Sayfalar dizine eklenmiyor değildi, geç ekleniyordu. Haber sitesinde rekabet dakikalarla ölçüldüğü için bu gecikme yüzünden trafik gelmiyordu. Sorunu çözdüğümüzde ertesi gün trafik %23 civarında arttı.
Bu hata hiçbir SEO aracının bize gösterdiği bir hata değildi. Sorunumuz geç indexlenmeydi; bunun nerelerden kaynaklanabileceğini analiz edip çözüme o şekilde ulaştık. Araçların göremediği bu tür sorunları nasıl aradığımızı 32. bölümde anlatıyorum.
Bu örnek bana şu konuyu tekrar hatırlattı:
Index problemi her zaman içerikten kaynaklanmıyor.
Bazen çok küçük görünen teknik bir detay, özellikle çok hızlı içerik üreten sitelerde ciddi SEO sorunlarına dönüşebiliyor.
Bir sayfa indexlendikten sonra ise iş bitmiyor. Bu sefer başka bir soru başlıyor:
Google bu sayfayı hangi aramalarda ve kaçıncı sırada gösterecek?
Uygulama
- Search Console’da Sayfa dizine ekleme (Page indexing) raporunu açın. “Dizine eklenmedi” altındaki nedenlerde önemli bir sayfanız var mı?
- En önemli 3 sayfanızı URL Denetleme’de kontrol edin. Dizinde mi, Google’ın seçtiği canonical sizin seçtiğinizle aynı mı?
- Sitenizde noindex olması gereken sayfalar (teşekkür, site içi arama, test) gerçekten noindex mi? Olmaması gereken bir sayfada kalmış mı?
- Filtre ve parametre URL’leriniz asıl sayfaya canonical veriyor mu?
- Birbirine çok benzeyen sayfalarınızı listeleyin. Her biri farklı bir ihtiyaca cevap veriyor mu, yoksa birleştirilebilir mi?
Önceki: 1. Bölüm, Tarama (Crawl) · İçindekiler · Sonraki: 3. Bölüm, Sıralama (Ranking)
Bu bölümün ilk hali X’te yayınlandı (29 Ağustos 2026).