
Son güncelleme: 1 Kasım 2026.
Bir sayfayı Google’da görmek istiyorsak önce Google’ın o sayfadan haberdar olması gerekiyor. Ardından sayfaya ulaşabilmesi, içeriği okuyabilmesi ve dizine almaya değer bulması gerekiyor.
Bu süreçte robots.txt, sitemap.xml, yönlendirmeler, HTTP durum kodları, canonical, noindex gibi kavramlar birbirinden bağımsız değil. Hepsi Googlebot’un site içerisinde nasıl hareket edeceğini etkiliyor.
Bence konuyu tek tek tanımlardan ziyade şu soru üzerinden anlatmak daha doğru:
Yeni bir URL oluşturduk. Google bu sayfayı nasıl bulacak ve sonrasında neler olacak?
1. Google bir URL’yi nasıl keşfediyor?
Google’ın yeni bir URL’den haberdar olmasının birkaç yolu var. En önemlilerinden ikisi bağlantılar ve site haritaları.
Örneğin yeni bir blog yazısı yayınladınız. Ana sayfadan, kategori sayfasından veya başka bir yazıdan bu içeriğe bağlantı verdiyseniz Googlebot bu bağlantıyı takip ederek yeni URL’yi keşfedebilir.
Bu yüzden 18. bölümde konuştuğumuz iç linkleme sadece kullanıcıyı başka sayfalara taşımıyor. Google’ın yeni ve mevcut sayfaları keşfetmesine de yardımcı oluyor. Google, taranabilir <a href> bağlantılarını yeni sayfaları bulmak için kullanıyor.
Diğer önemli kaynak ise sitemap.xml.
2. sitemap.xml ne işe yarıyor?
Site haritası (sitemap), Google’a sitemizde önemli olduğunu düşündüğümüz URL’leri bildirdiğimiz dosya.
Örneğin şunlar site haritası aracılığıyla Google’a bildirilebilir:
- Ürünler
- Kategoriler
- Blog yazıları
- Haberler
- Videolar
- Görseller
Ama burada sık gördüğüm bir yanlış anlaşılma var:
Sitemap’e URL eklemek, Google’ın o URL’yi mutlaka tarayacağı veya dizine ekleyeceği anlamına gelmez.
Sitemap bir garanti değil, güçlü bir keşif aracıdır. Google da sitemap gönderimini bir sinyal olarak değerlendiriyor; URL’lerin mutlaka taranacağını veya dizine ekleneceğini garanti etmiyor.
3. Sitemap’e hangi URL’leri koymalıyız?
Bence basit bir mantıkla yaklaşabiliriz:
Google’da görmek istediğimiz esas URL’leri sitemap’e koymalıyız.
Örneğin genellikle şu sayfalar sitemap içerisinde bulunmalı:
- 200 durum kodu dönen
- Dizine açık
- Tercih ettiğimiz Standart URL (Canonical) olan
- Kullanıcı açısından anlamlı
- Google’da görünmesini istediğimiz
Google’ın kendisi de sitemap’e arama sonuçlarında görmek istediğimiz URL’leri eklememizi öneriyor. Ayrıca Google <priority> ve <changefreq> değerlerini dikkate almıyor; doğru kullanıldığında <lastmod> bilgisinden yararlanabiliyor.
Yani sitemap dosyasına her oluşturulan URL’yi doldurmak bence doğru yaklaşım değil.
4. Sitemap konusunda yaşadığımız gerçek bir problem
Büyük bir haber sitesiyle çalışırken yeni haberlerin Google’a geç düştüğü bir problem yaşamıştık. Haber yayınlanıyordu ama Google bazen yeni URL’yi geç fark ediyordu.
Teknik tarafı incelerken sitemap dosyasının sunucu yükünü azaltmak amacıyla yaklaşık 10 dakika önbelleğe alındığını (cache) gördük. Yani haber saat 10:00’da yayınlanıyor ama URL sitemap içerisinde 10:10 civarında görünüyordu.
Normal bir kurumsal site için 10 dakika çok önemli olmayabilir. Ama haber sitesinde bazen 10 dakika ciddi bir süre.
Cache süresini saniyeler seviyesine düşürdükten sonra yeni haberlerin sitemap’e çok daha hızlı girdiğini ve gecikmeli indeksleme probleminin büyük ölçüde azaldığını gördük.
Bu örneği özellikle seviyorum çünkü teknik SEO’da küçük görünen bir ayarın iş modeline göre ne kadar önemli olabileceğini gösteriyor.
Bir e-ticaret sitesi, kurumsal site ve haber sitesinin tarama ihtiyaçları aynı değil.
5. Google URL’yi buldu, şimdi robots.txt dosyasına bakıyor
robots.txt en çok yanlış anlaşılan SEO dosyalarından biri.
Basit olarak robots.txt ile arama motoru tarayıcılarına “Sitemin şu bölümlerini tarayabilirsin, şu bölümlerine girme.” diyoruz.
Örneğin:
User-agent: *
Disallow: /admin/
Googlebot’a /admin/ altındaki URL’leri taramamasını söylüyoruz.
robots.txt sitenin kök dizininde yer alır: site.com/robots.txt
Google’ın otomatik tarayıcıları bir siteyi taramadan önce robots.txt kurallarını kontrol eder.
6. robots.txt ile Google’dan sayfa kaldırılmaz
Bence robots.txt ile ilgili öğrenilmesi gereken en önemli konulardan biri bu.
robots.txt tarama kontrolüdür. noindex ise dizine ekleme kontrolüdür. Bunlar aynı şey değil.
Bir URL’yi robots.txt ile engellediğinizde Google o sayfanın içeriğini tarayamaz. Ama URL’yi başka yerlerden öğrenmişse bazı durumlarda URL’nin kendisi arama sonuçlarında içerik açıklaması olmadan görünebilir. Google bunu kendi robots.txt dokümantasyonunda da açıkça belirtiyor.
Bu yüzden “Bu sayfa Google’da kesinlikle görünmesin.” diyorsanız robots.txt her zaman doğru çözüm değildir.
7. Dizine Almama (Noindex) nedir?
Bir sayfanın Google sonuçlarında yer almasını istemiyorsak kullanılabilecek yöntemlerden biri noindex.
Örneğin sayfada şu etiket bulunabilir:
<meta name="robots" content="noindex">Googlebot sayfayı taradığında bu etiketi görür ve sayfanın Google sonuçlarında gösterilmemesi gerektiğini anlar.
Ama burada çok kritik bir detay var:
Google noindex etiketini görebilmek için önce sayfayı tarayabilmeli.
Sayfayı robots.txt ile engelleyip aynı zamanda noindex kullanırsanız Google sayfaya erişemediği için noindex etiketini de göremeyebilir. Google’ın kendi dokümantasyonu da noindex’in çalışabilmesi için sayfanın robots.txt tarafından engellenmemesi gerektiğini özellikle belirtiyor.
Kısaca:
- robots.txt: Tarama
- noindex: Dizin
Bu farkı bilmek birçok teknik SEO problemini daha oluşmadan çözüyor.
8. Google sayfaya ulaştığında sunucu ne cevap veriyor?
Tarayıcı bir URL’ye geldiğinde sunucudan bir HTTP durum kodu alıyor.
SEO çalışırken hepsini ezberlemeye gerek yok ama bazılarını mutlaka bilmek gerekiyor:
| Durum kodu | Anlamı |
|---|---|
| 200 | Sayfa başarıyla açılıyor |
| 301 | Kalıcı yönlendirme |
| 302 | Geçici yönlendirme |
| 404 | Sayfa bulunamadı |
| 410 | İçerik kaldırılmış |
| 429 | Çok fazla istek |
| 5xx | Sunucu tarafında problem |
Bu kodlar sadece yazılımcıları ilgilendirmiyor. Google’ın URL ile ne yapacağını da etkiliyor.
9. 200 durum kodu her şey yolunda demek mi?
Bir sayfanın 200 döndürmesi temel olarak sunucunun isteğe başarılı cevap verdiğini gösteriyor.
Ama 200 = Google kesinlikle dizine ekler demek değil.
Sayfa taranabilir, 200 döndürebilir ve yine de Google tarafından dizine alınmayabilir. Çünkü tarama ile dizinleme aynı süreç değil.
Google taradığı sayfaları daha sonra değerlendiriyor. İçeriğin kopya olup olmadığı, canonical sinyalleri veya sayfanın dizine uygunluğu gibi başka faktörler devreye giriyor. Google’ın tarama bütçesi dokümantasyonunda da taranan her sayfanın dizine eklenmeyeceği açıkça belirtiliyor.
10. 301 Kalıcı Yönlendirme (301 Permanent Redirect)
Bir URL kalıcı olarak başka bir URL’ye taşındıysa 301 kullanabiliriz.
Örneğin eski ürün URL’miz site.com/eski-kahve-makinesi, yeni adres site.com/yeni-kahve-makinesi olmuşsa ve gerçekten aynı ürünün yeni adresiyse şu şekilde yönlendirme yapılabilir:
eski URL → 301 → yeni URL
Bu hem kullanıcıyı doğru sayfaya götürür hem de Google’a eski URL’nin kalıcı olarak yeni adrese taşındığı konusunda güçlü bir sinyal verir. Google kalıcı yönlendirmeleri canonical hedefi konusunda güçlü sinyaller arasında sayıyor ve 301 gibi kalıcı yönlendirmelerin PageRank kaybına neden olmadığını belirtiyor.
11. 302 Geçici Yönlendirme (302 Temporary Redirect)
302 ise değişikliğin geçici olduğunu anlatır.
Örneğin kısa süreli bir kampanya nedeniyle kullanıcıyı başka bir sayfaya gönderiyor ancak ileride eski URL’yi tekrar kullanmayı düşünüyorsanız 302 anlamlı olabilir.
Google 301’i hedef URL’nin esas URL olması gerektiğine dair daha güçlü, 302’yi ise daha zayıf bir sinyal olarak değerlendiriyor.
Pratikte asıl soru şu olmalı:
Değişiklik kalıcı mı, geçici mi?
Durum kodunu buna göre seçmek gerekiyor.
12. Her 404 sayfasını yönlendirmeli miyiz?
Hayır.
SEO çalışmalarında uzun süre şöyle bir refleks oluştu: “404 gördüğümüz her şeyi 301 yapalım.” Bence bu yanlış.
Bir ürün kaldırıldıysa ve yerine gerçekten benzer veya yeni bir ürün geldiyse yönlendirme mantıklı olabilir. Ama 2017 yılında yaptığınız bir etkinliğin sayfasını sırf 404 vermesin diye ana sayfaya yönlendirmek kullanıcı açısından da çok anlamlı değil.
Bir URL gerçekten artık yoksa 404 dönmesi normaldir.
Google da 404 ve diğer 4xx durum kodlarını içerik artık yok şeklinde değerlendiriyor ve daha önce dizinde olan URL’leri zaman içerisinde dizinden çıkarıyor.
404 her zaman teknik SEO hatası değildir.
Yanlış 404 hata olabilir. Doğru 404 normaldir.
13. 404 ile 410 arasında büyük bir SEO savaşı vermeye gerek yok
410 Gone, içeriğin bilinçli şekilde kaldırıldığını ifade eder. 404 ise bulunamadığını söyler.
Google güncel dokümantasyonunda 404 ve 410 dahil çoğu 4xx durum kodunu Google Search açısından benzer biçimde ele alıyor: URL’nin içeriğinin mevcut olmadığı kabul ediliyor.
Bu yüzden saatlerce “404 mü verelim, 410 mu?” tartışması yapmak yerine, çoğu projede daha önemli teknik problemlere odaklanmak gerektiğini düşünüyorum.
14. Yönlendirme Zinciri (Redirect Chain)
Şöyle bir yapı düşünelim: A → B → C → D
Kullanıcı A URL’sine giriyor. A, B’ye yönlendiriyor. B, C’ye. C de D’ye. Sonunda içerik D’de açılıyor.
Buna Yönlendirme Zinciri (Redirect Chain) diyoruz.
Mümkünse A → D şeklinde doğrudan yönlendirmek daha temiz.
Google uzun yönlendirme zincirlerinden kaçınılmasını öneriyor; gereksiz yönlendirmeler hem taramayı hem kullanıcı deneyimini zorlaştırabilir.
Özellikle yıllardır çalışan sitelerde bu zincirleri çok görüyoruz. Eski URL bir kez değiştirilmiş. Üç yıl sonra tekrar değiştirilmiş. Sonra site yenilenmiş. Her ekip yeni bir yönlendirme eklemiş. Bir süre sonra URL’nin geçmişi aile ağacına dönüyor.
15. Yönlendirme Döngüsü (Redirect Loop)
Daha kötü senaryo şu: A → B ama B → A
Kullanıcı ve Google sürekli iki URL arasında dönüyor. Sayfa hiç açılmıyor.
Buna Yönlendirme Döngüsü (Redirect Loop) diyoruz.
Bazen HTTPS geçişleri, www / non-www ayarları veya yanlış CDN / sunucu kuralları nedeniyle oluşabiliyor.
Burada SEO’dan önce temel problem şu:
Sayfa erişilebilir değil.
16. Standart URL (Canonical) ne işe yarıyor?
Bir sayfanın birden fazla URL ile açılabildiğini düşünelim. Örneğin:
site.com/ayakkabi
site.com/ayakkabi?renk=siyah
site.com/ayakkabi?utm_source=instagram
Bazı durumlarda içerikler tamamen veya büyük ölçüde aynı olabilir.
Google bu URL’leri inceleyip içlerinden birini Standart URL (Canonical URL) olarak seçebilir.
Biz de şu etiketle Google’a tercih ettiğimiz URL’yi söyleyebiliriz:
<link rel="canonical" href="https://site.com/ayakkabi">Ama burada da önemli bir kelime var: Tercih.
Canonical bir emir değil, güçlü bir sinyaldir. Google gerekli görürse bizim belirttiğimiz URL’den farklı bir canonical seçebilir.
17. Canonical ile 301 aynı şey değil
Bu ikisi sık karıştırılıyor.
301 yaptığınızda kullanıcı da Google da başka URL’ye gider. Canonical kullandığınızda ise iki sayfa kullanıcı açısından hâlâ erişilebilir olabilir.
Örneğin renk filtreli bir kategori sayfası (/ayakkabi?renk=siyah) kullanıcı açısından gerekli olabilir. Kullanıcı burada siyah ayakkabıları görür. Ama Google’a ana kategori URL’sinin standart sürüm olduğunu belirtmek isteyebilirsiniz. Bu durumda canonical kullanılabilir.
Yani canonical “Bu sayfayı kapat.” demek değildir.
Daha çok “Bu benzer URL grubu içerisinde benim tercih ettiğim esas URL bu.” demektir.
18. Sitemap ve canonical birbiriyle çelişmemeli
Bence teknik SEO’da çok basit ama sık yapılan hatalardan biri bu.
Sayfanın canonical etiketi site.com/urun-a diyor. Ama sitemap içerisinde site.com/urun-a?ref=xyz bulunuyor.
Bir taraftan Google’a “Asıl URL bu.” diyoruz. Diğer taraftan “Benim önemli URL’m şu.” diyoruz.
Google sitemap’e eklenen URL’leri canonical konusunda bir sinyal olarak değerlendirebiliyor. Bu yüzden teknik sinyallerin mümkün olduğunca birbirini desteklemesi daha temiz bir yapı oluşturuyor.
19. Nofollow nedir?
Bir bağlantının üzerinde rel="nofollow" görebilirsiniz. Burada Google’a bağlantıyla ilgili bir ilişki sinyali veriyoruz.
Ancak nofollow hakkında eski bilgiler internette hâlâ çok fazla.
Google artık nofollow, sponsored ve ugc gibi bağlantı niteliklerini Search açısından katı bir “asla takip etme” komutu yerine ipucu (hint) olarak değerlendiriyor.
Bu yüzden “Bu sayfanın taranmasını kesinlikle engellemek istiyorum, iç linklere nofollow koyayım.” mantığı doğru yöntem değil.
Google da kendi sitenizde bir URL’nin alınmasını engellemek istiyorsanız robots.txt gibi uygun yöntemleri kullanmanızı; dizine girmesini istemiyorsanız sayfayı taramaya açık bırakıp noindex kullanmanızı öneriyor.
20. Tarama Bütçesi (Crawl Budget) nedir?
Google’ın bütün interneti sınırsız şekilde tarayabilecek sonsuz kaynağı yok.
Her siteye ayrılan bir tarama kapasitesi ve tarama talebi bulunuyor. Bunların birleşimini kabaca Tarama Bütçesi (Crawl Budget) olarak ifade ediyoruz.
Ancak burada da SEO sektöründe biraz gereğinden fazla korku oluşturulduğunu düşünüyorum. 50 sayfalık kurumsal bir sitenin “Crawl budget’ımızı nasıl optimize edeceğiz?” diye ciddi zaman harcaması çoğu zaman gereksiz.
Google’ın güncel rehberi de tarama bütçesi optimizasyonunu özellikle çok büyük veya çok sık güncellenen siteler için ileri düzey bir konu olarak tanımlıyor. Örnek olarak milyonlarca URL’ye sahip büyük siteleri veya on binlerce URL’si çok hızlı değişen siteleri veriyor.
Ama milyonlarca ürün URL’si, filtre kombinasyonları veya sürekli yeni haber üreten büyük bir site yönetiyorsanız konu önemli hale geliyor.
21. Tarama bütçesini neler boşa harcayabilir?
Özellikle büyük sitelerde şunlar problem oluşturabilir:
- Gereksiz filtre URL’leri
- Sıralama parametreleri
- Aynı içeriğin yüzlerce URL ile açılması
- Sonsuz takvim URL’leri
- Uzun yönlendirme zincirleri
- Soft 404 sayfaları
- Yavaş sunucu cevapları
- Sürekli 5xx hataları
- Tarama değeri olmayan çok sayıda URL
Örneğin bir e-ticaret sitesinde ?renk=siyah, ?beden=m, ?sirala=fiyat, ?marka=x parametreleri birbiriyle birleşip yüz binlerce URL oluşturabilir.
Gerçekte 10.000 ürününüz vardır ama Google milyonlarca farklı URL kombinasyonu keşfedebilir.
Teknik SEO’nun önemli görevlerinden biri de Google’a gerçekten önemli URL’leri daha net göstermek.
22. Sunucu performansı taramayı etkileyebilir
Google sitenizi tararken sunucuyu çökertmek istemiyor.
Sunucunun cevap süreleri kötüleşir veya çok sayıda 5xx / 429 hatası oluşursa Google tarama hızını azaltabiliyor. Sunucu tekrar sağlıklı 2xx cevapları vermeye başladığında tarama kapasitesi kademeli olarak artabiliyor.
Bu yüzden bazı tarama problemleri SEO eklentisinden değil, şunlardan kaynaklanabilir:
- Sunucudan
- CDN’den
- Veritabanından
- Cache sisteminden
- Uygulama altyapısından
Teknik SEO biraz da bu yüzden sadece “meta etiketleri kontrol etmek” değildir. Sunucu ve site hızı tarafına bir sonraki bölümde bakıyoruz.
23. Sayfalama (Pagination) nasıl ele alınmalı?
Bir e-ticaret kategorisinde 2.000 ürün olduğunu düşünelim. Hepsini tek sayfaya yüklemiyoruz, şöyle sayfalara ayırıyoruz:
/kahve-makineleri?page=1
/kahve-makineleri?page=2
/kahve-makineleri?page=3
Burada Google’ın sonraki sayfalara ulaşabilmesi önemli.
Google güncel dokümantasyonunda her sayfalama sayfasına ayrı URL verilmesini, sayfaların birbirine taranabilir <a href> bağlantılarıyla bağlanmasını ve her sayfanın kendi canonical URL’sini kullanmasını öneriyor. Bütün sayfalama sayfalarını birinci sayfaya canonical yapmak doğru yaklaşım değil.
Ayrıca eski SEO eğitimlerinde sık gördüğümüz şu etiketleri Google artık sayfalama ilişkisini anlamak için kullanmıyor:
<link rel="next" href="...">
<link rel="prev" href="...">
SEO’da eski bilgiyi güncel bilgi kadar kontrol etmek gerekiyor.
24. Sonsuz kaydırma varsa Google bütün ürünleri görür mü?
Her zaman değil.
Kullanıcı aşağı indikçe yeni ürünlerin JavaScript ile gelmesi güzel bir deneyim olabilir. Ama Googlebot kullanıcı gibi ekranda aşağı doğru kaydırıp “Daha Fazla Yükle” butonuna basmaz.
Google’ın kendi dokümantasyonu da tarayıcıların kullanıcı etkileşimi gerektiren butonları genel olarak tıklamadığını belirtiyor. Bu nedenle sonsuz kaydırma veya “daha fazla yükle” kullanılan yapılarda içeriklerin benzersiz URL’lerle ve taranabilir bağlantılarla erişilebilir olması önemli.
Kullanıcının görebildiği 500 ürünün Googlebot tarafından sadece ilk 20’sinin keşfedilebildiği bir yapı istemeyiz.
25. Mobil Öncelikli İndeksleme (Mobile-First Indexing)
Google artık sitenin mobil sürümündeki içeriği temel alarak dizinleme ve sıralama yapıyor. Buna Mobil Öncelikli İndeksleme (Mobile-First Indexing) diyoruz.
Bu yüzden masaüstünde çok güzel ve kapsamlı bir sayfa hazırlayıp mobil sürümde içeriğin yarısını kaldırmak problem yaratabilir.
Özellikle kontrol edilmesi gerekenler:
- Ana içerik mobilde mevcut mu?
- Başlıklar aynı mı?
- Görseller erişilebilir mi?
- İç linkler mobilde de var mı?
- Yapılandırılmış veriler tutarlı mı?
- robots.txt mobil kaynakları engelliyor mu?
Responsive tasarım bu açıdan işleri genellikle kolaylaştırıyor; Google da uygulanması ve bakımı daha kolay olduğu için responsive yaklaşımı öneriyor.
26. Tarama ile dizinleme arasındaki fark
Bence bu bölümün en önemli ayrımlarından biri yine burada.
Google sayfanızı keşfedebilir. Sonra tarayabilir. Ama yine de dizine eklemeyebilir.
Örneğin Google sayfayı taradıktan sonra başka bir URL’yi canonical olarak seçebilir veya sayfanın dizine alınmasına gerek olmadığına karar verebilir.
Bu yüzden Search Console’da “Tarandı: Şu anda dizine eklenmiş değil (Crawled – currently not indexed)” benzeri bir durum gördüğümüzde “Google sayfamı bulamamış.” demek doğru değildir.
Google bulmuş ve taramıştır. Problem sürecin başka bir aşamasındadır.
Teknik SEO’da bu ayrımı yapmadan problem çözmeye çalışmak ciddi zaman kaybettirir.
27. Googlebot bir sayfaya ulaşamıyorsa önce nerelere bakıyorum?
Ben kabaca şu sırayla kontrol etmeyi seviyorum:
- URL gerçekten açılıyor mu?
- Hangi HTTP durum kodunu döndürüyor?
- robots.txt engelliyor mu?
- noindex var mı?
- Canonical hangi URL’yi gösteriyor?
- Sitemap içerisinde bulunuyor mu?
- Site içerisinden bağlantı alıyor mu?
- JavaScript olmadan bağlantı keşfedilebiliyor mu?
- Yönlendirme var mı?
- Yönlendirme zinciri oluşmuş mu?
- Mobil Googlebot aynı içeriği görebiliyor mu?
- Sunucu hataları var mı?
- Search Console URL Denetleme (URL Inspection) ne söylüyor?
Bunlara baktığınızda problemin büyük kısmı zaten daralmaya başlıyor.
28. Bence teknik SEO’da en büyük hata tek bir etikete bakmak
Örneğin geliştirici “Canonical doğru.” diyor.
Ama sitemap başka URL gösteriyor. İç linkler üçüncü URL’ye gidiyor. 301 dördüncü URL’ye yönlendiriyor. Bir yerde noindex var. robots.txt de başka bir alanı kapatmış.
Bu durumda tek tek bütün ayarlar teknik olarak “çalışıyor” olabilir ama Google’a çelişkili sinyaller gönderiyoruz.
Ben teknik SEO’ya biraz şöyle bakıyorum:
Google’a mümkün olduğunca açık ve tutarlı bir yol çizmek.
Hangi URL önemli? Hangisi taranmalı? Hangisi dizine girmeli? Hangisi artık yok? Hangisi başka yere taşındı? Hangisi aynı içeriğin farklı sürümü?
Bunların cevabı ne kadar netse Google’ın siteyi anlaması da o kadar kolaylaşıyor.
Özetlersek
Google’ın bir sayfayı arama sonuçlarına taşıyan yolu kabaca şöyle düşünebiliriz:
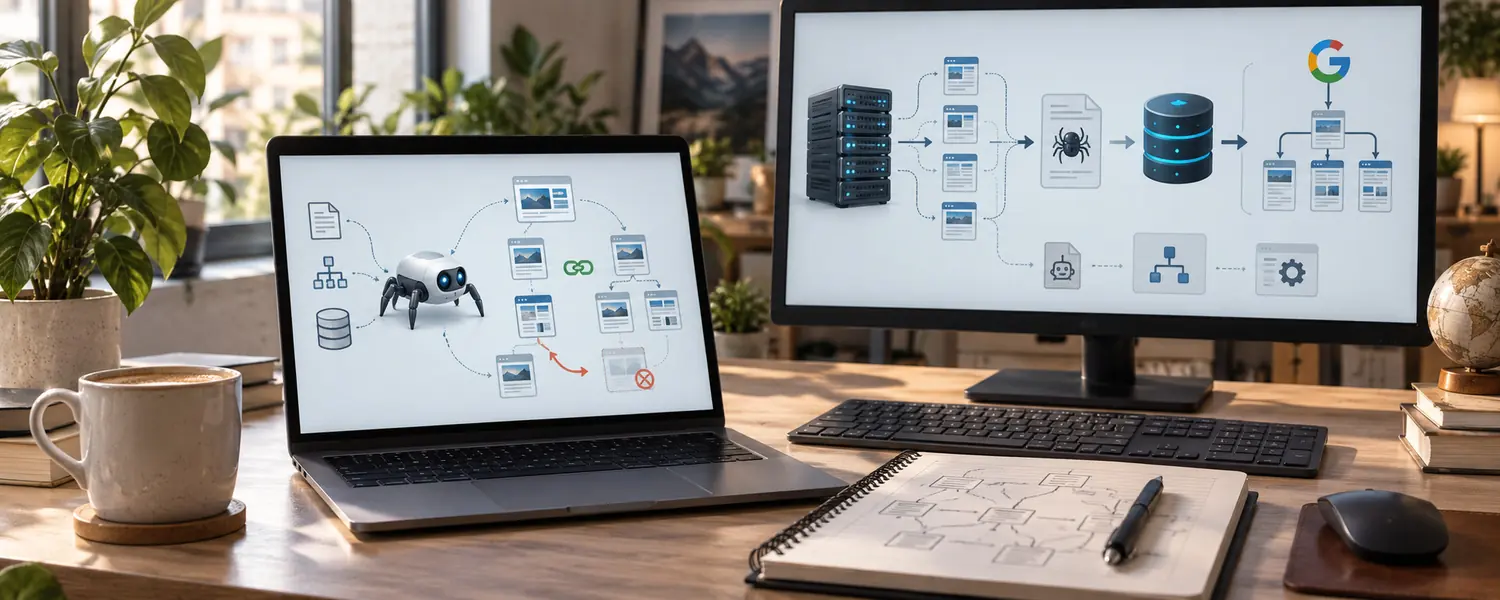
URL’yi keşfet → Tarama izni var mı kontrol et → Sayfayı iste → HTTP cevabını al → İçeriği oku → Benzer URL’leri değerlendir → Canonical seç → Dizinleme kararı ver → Zaman içerisinde tekrar tara
robots.txt, sitemap.xml, 301, 302, 404, canonical, noindex, pagination ve tarama bütçesi aslında bu sürecin farklı noktalarını yönetiyor.
Bunların her birini ezberlemekten daha önemli olan şey hangi aracın hangi problemi çözdüğünü anlamak.
robots.txt ile dizin yönetmeye, canonical ile sayfa kaldırmaya veya 301 ile alakasız her 404’ü ana sayfaya göndermeye çalıştığımızda sorunlar başlıyor.
Teknik SEO’da çoğu zaman iyi çözüm karmaşık değil.
Googlebot’un önündeki yolu temizlemek ve ona birbiriyle çelişmeyen sinyaller vermek.
Önceki: 22. Bölüm, İçerik Yazmadan Önce Plan Nasıl Yapılır? · İçindekiler · Sonraki: 24. Bölüm, Site Neden Yavaş Açılıyor?
Bu bölümün ilk hali X’te yayınlandı (25 Eylül 2026).