
Son güncelleme: 1 Kasım 2026.
Bir satın alma müdürü ChatGPT’ye “Günde 3.000 şişe köpüren ürün dolduracağım, Türkiye’de hangi üreticilere bakmalıyım?” yazıyor ve birkaç saniye sonra üç dört firmalık bir liste alıyor. O birkaç saniyede model bir dizi iş yapıyor. Bu işlerin çoğu, sitenizde neyi düzeltmeniz gerektiğini doğrudan belirliyor.
Mekanizmayı bilmenin pratik bir faydası var. “İçeriği küçük parçalara bölün”, “her soru için ayrı sayfa açın”, “yapay zekâda 1. sıraya çıkın” gibi tavsiyeler sık dolaşıyor ve çoğu bu mekanizma bilinmeden yazılıyor. Cevabın nasıl kurulduğunu bilen biri, bunların hangisinin işe yaradığını, hangisinin zaman kaybı olduğunu kendisi ayırabiliyor.
Model mimarisine girmeyeceğim. Bir pazarlama yöneticisinin, site sahibinin ya da SEO uzmanının karar verirken bilmesi gereken kadarı yeterli.
1. Hafıza ve canlı arama
Bir yapay zekâ modeli bir soruyu iki yerden cevaplayabiliyor.
Biri modelin hafızası, yani eğitim verisi. Model eğitim sırasında çok büyük miktarda metin okuyor ve dil, konular, markalar hakkında genel bir bilgi ediniyor. Bu bilgi bir kesim tarihinde donuyor; model o tarihten sonra olanları hafızasından bilemiyor. Okuduklarını kelimesi kelimesine de saklamıyor, metinlerden örüntüler öğreniyor. Bu yüzden hafızadan verilen bir cevap kaynak gösteremiyor. Markanız hakkında bildikleri de eğitim verisinde ne kadar ve nasıl geçtiğinize bağlı.
Diğeri canlı arama. Soru güncel bir bilgi, bir fiyat, bir adres ya da bir ürün karşılaştırması gerektiriyorsa model web’de arıyor, bulduklarını okuyor ve cevabı onlardan yazıyor. OpenAI bunu ChatGPT için “ChatGPT will choose to search the web based on what you ask” diye anlatıyor; arama yapıp yapmayacağına sorunuza bakarak model karar veriyor (OpenAI). Google’ın AI Bakışı ve AI Modu ise cevaplarını her zaman Google’ın arama dizinindeki sayfalara dayandırıyor.
İki kaynağın iş tarafındaki karşılığı farklı. Canlı arama kısa vadeli ve sizin kontrol edebildiğiniz taraf: Bugün yayınladığınız, düzelttiğiniz ya da dizine aldırdığınız bir sayfa birkaç gün içinde yapay zekâ cevaplarına girebilir. 2. bölümde anlattığımız temel bu tarafın temeli. Eğitim verisi ise uzun vadeli. Markanız hakkında web’de yıllar içinde ne yazıldığı, hangi sitelerde nasıl anlatıldığı bir sonraki model güncellemesinde modelin hafızasına yansıyor. O tarafa 13. ve 14. bölümlerde, marka ve üçüncü taraf kaynaklar konuşulurken döneceğiz.
Hangisinin devreye girdiği sorunun türüne bağlı. “Dolum makinesi nedir?” sorusunu model hafızasından da cevaplayabilir, çünkü cevabı zamanla pek değişmiyor. “Günde 3.000 şişe köpüren ürün dolduracağım, Türkiye’de hangi üreticilere bakmalıyım?” ise güncel ve ticari bir bilgi istiyor. Bu tür sorularda model büyük ihtimalle arama yapıyor.
Bu, işletmeler için iyi bir haber. Satışa en yakın soruların çoğu güncel bilgi istiyor ve aramaya gidiyor. İşiniz için en değerli sorularda etkileyebildiğiniz taraf devrede.
2. Cevap arama sonuçlarının üzerine kuruluyor
Yapay zekânın aramayla cevap vermesinin teknik adı RAG (Retrieval-Augmented Generation), Türkçesiyle “getirmeyle desteklenmiş üretim”. Google aynı şeye dayanak (grounding) diyor. Model önce bilgiyi getiriyor, sonra o bilgiye dayanarak yazıyor. Süreç kabaca altı adımda işliyor:
- Model sorunun ne istediğini ve hangi bilgilere ihtiyaç olduğunu çıkarıyor.
- Soruyu bir ya da birden fazla arama sorgusuna çeviriyor. Sorgu yelpazesi dediğimiz adım bu.
- Bu aramaların sonuçlarından sayfalar getiriyor.
- Getirdiği sayfaları okuyup soruyla ilgili parçaları seçiyor.
- Cevabı bu parçalardan, kendi cümleleriyle yazıyor.
- Cevabı destekleyen sayfalara link veriyor.
Site sahibini en çok üçüncü adım ilgilendiriyor. Google, AI özellikleri için sayfaları getirirken kendi temel sıralama sistemlerini kullandığını açıkça yazıyor: “relying on our core Search ranking systems to retrieve relevant, up-to-date web pages from our Search index” (Google Search Central). Yapay zekânın okuduğu sayfalar, klasik aramada iyi sıralanan sayfaların arasından geliyor.
Kitabın 2. bölümünün neden bu kadar uzun tutulduğu da buradan anlaşılıyor. Model interneti baştan sona okumuyor. Her soru için sınırlı sayıda sayfa okuyor ve o sayfaları arama motorunun sıralaması belirliyor. Taranmayan, dizinde olmayan ya da ilgili aramalarda bulunamayan bir sayfa, ne kadar iyi yazılmış olursa olsun okunacaklar arasına girmiyor.
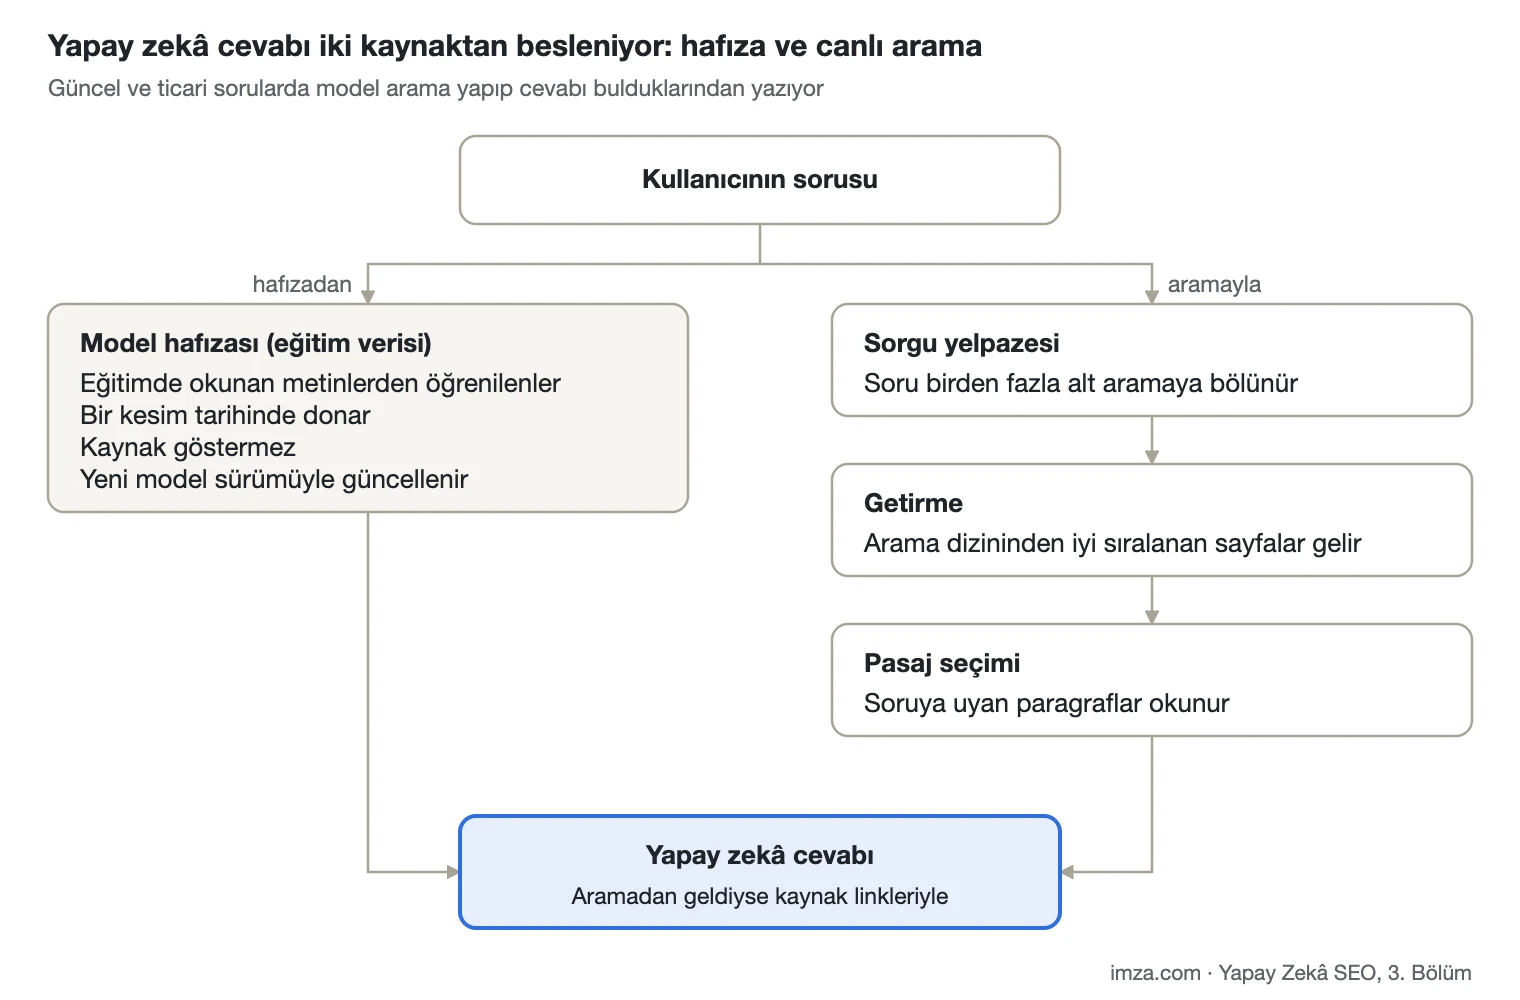
Soldaki yol modelin hafızası; kısa vadede etkileyemediğiniz taraf. Sağdaki yol canlı arama; 2. bölümdeki temelin ve bu bölümde anlatılan adımların işlediği taraf.
3. Tek soru, birçok arama
Sorgu yelpazesinden (query fan-out) ilk bölümde kısaca bahsetmiştik. Yapay zekâ aramasını klasik aramadan en çok ayıran şey bu olduğu için biraz açmak gerekiyor.
Google sorgu yelpazesini “A set of concurrent, related queries generated by the model to request more information” diye tanımlıyor, yani modelin daha fazla bilgi toplamak için aynı anda ürettiği ilgili aramalar. Google’ın kendi örneğinde, çim alanını ot basmış bir kullanıcı için model arka planda “best herbicides for lawns” gibi bir arama da yapıyor (Google Search Central).
Google’ın Arama’dan sorumlu Ürün Başkan Yardımcısı Robby Stein, Temmuz 2025’te sürecin birkaç detayını paylaştı (Search Engine Journal). Model, kullanıcının hiç sormadığı ama soruyla ilgili konuları da arıyor; kalabalık bir grupla Nashville’e gidecek biri için restoranları, barları ve çocuklarla yapılabilecek aktiviteleri ayrı ayrı arayabiliyor. Sadece web sonuçlarına değil, Shopping Graph gibi gerçek zamanlı veri kaynaklarına da bakıyor. Stein’a göre bu ürün kataloğunda yaklaşık 50 milyar ürün var ve katalog saatte yaklaşık 2 milyar kez güncelleniyor. Daha derin araştırma isteyen sorularda ise Deep Search arka planda düzinelerce, hatta yüzlerce arama yapabiliyor ve bu birkaç dakika sürebiliyor.
Dolum makinesi örneğine dönelim. Kullanıcı “Günde 3.000 şişe köpüren ürün dolduracağım, hangi makineyi almalıyım?” diye soruyor. Model bu soruyu arka planda şu tür aramalara bölebilir:
- köpüren sıvılar nasıl doldurulur
- dalıcı nozullu ve pistonlu dolum makinesi farkı
- günde 3.000 şişe kapasiteli dolum makinesi
- dolum makinesi fiyatları
- Türkiye’deki dolum makinesi üreticileri
- dolum makinesi servis ve yedek parça
Bu aramaları ben örnek olsun diye yazdım. Gerçekte hangi aramaların yapıldığını ne Google ne de OpenAI site sahiplerine gösteriyor. Mantık ise aynı: Kullanıcının tek sorusu, her biri ayrı bir sonuç sayfası olan birkaç aramaya dönüşüyor.
Bunun ilk sonucu, ana kelimede üst sırada olmanın artık yetmemesi. “Dolum makinesi” aramasında birinci olabilirsiniz, ama model cevabını “köpüren sıvılar nasıl doldurulur” aramasında çıkan bir rakip sayfadan yazabilir. 1. bölümde gördüğümüz Ahrefs verisi, yani AI Bakışı’nda kaynak gösterilen sayfaların önemli bir kısmının ana aramada ilk 10’da olmaması, büyük ölçüde bununla açıklanıyor.
Bu, her alt arama için ayrı sayfa açmak gerektiği anlamına gelmiyor. Google bu konuda açık bir uyarı yapıyor. Aramaların her olası varyasyonu için ayrı içerik üretmek cazip gelebilir, ama bunu esas olarak sıralamayı ya da yapay zekâ cevaplarını manipüle etmek için yaparsanız ölçekli içerik kötüye kullanımı (scaled content abuse) politikasını ihlal edebilirsiniz (Google Search Central).
Yapılacak iş daha sıkıcı ama daha sağlam. Kullanıcının karar verirken soracağı alt soruları listeleyin, mevcut sayfalarınızda cevaplanıp cevaplanmadığına bakın ve eksikleri tamamlayın. Bir alt soru ayrı bir ihtiyaca karşılık geliyorsa, mesela teknik bir karşılaştırma ya da bir kapasite hesabıysa, onun için ayrı bir sayfa zaten kendiliğinden gerekir. Bu soruları nasıl bulacağımız 6. bölümün konusu.
4. Model sayfanın bir parçasını seçiyor
Getirilen sayfaların hepsi cevaba girmiyor. Model her sayfadan soruya en uygun parçayı seçiyor ve cevabı bu parçalardan kuruyor. Klasik aramada sayfa bütün olarak sıralanıyordu. Yapay zekâ cevabında ise çoğu zaman sayfanın içindeki bir paragraf, bir tablo satırı ya da bir tanım yarışıyor.
Google da sistemlerinin bir sayfadaki birden fazla konuyu ayırt edebildiğini ve kullanıcıya ilgili parçayı gösterebildiğini yazıyor (Google Search Central).
Bu bilgi sık yanlış yorumlanıyor. “Yapay zekâ paragraf okuyorsa içeriğimi küçük parçalara böleyim” tavsiyesi 2025 boyunca çok dolaştı ve Google buna açıkça karşı çıktı. Danny Sullivan, Ocak 2026’da Google’ın Search Off the Record podcast’inde içeriği yapay zekâ için lokma lokma bölme tavsiyesi hakkında “We don’t want you to do that” dedi (Search Engine Land). Google’ın rehberi de içeriği yapay zekâ daha iyi anlasın diye küçük parçalara bölme zorunluluğu olmadığını, ideal bir sayfa uzunluğu da bulunmadığını söylüyor.
İşe yarayan, iyi yazılmış bir sayfanın zaten yaptığı şeyler. Her paragraf kendi bağlamını taşımalı. “Bu makine günde 3.000 şişe doldurur” cümlesi tek başına okunduğunda hangi makineden bahsedildiği belli değil; “X-200 dolum makinesi günde 3.000 şişe doldurur” ise paragrafın dışına çıkarıldığında da anlaşılıyor. Kapasite, fiyat aralığı, teslim süresi, garanti ve hizmet verdiğiniz bölge gibi bilgiler sayıyla ve açıkça yazıldığında yapay zekânın onları doğru aktarma ihtimali artıyor.
Başlıklar da altındaki içeriği anlatmalı. “Detaylar” yerine “Köpüren ürünlerde dolum hızı” gibi bir başlık, okuyucuya da modele de paragrafın neyi cevapladığını söylüyor. Bir soruya cevap veren bölümde cevabı ilk cümlelerde verip detayı sonra anlatmak da aynı işi görüyor.
Bunların hiçbiri yeni bir teknik sayılmaz, iyi editörler yıllardır aynı şeyi söylüyor. Okunabilir ve alıntılanabilir sayfa 10. bölümün konusu.
5. Anılmak, önerilmek ve kaynak gösterilmek
Model seçtiği parçaları alt alta yapıştırmıyor. Onları okuyup kendi cümleleriyle yeni bir metin yazıyor ve cevabı destekleyen sayfalara link veriyor. Google bunu cevabı destekleyen sayfalara belirgin, tıklanabilir linkler göstermek olarak tarif ediyor. ChatGPT’de de cevabın altındaki Kaynaklar düğmesi kullanılan sayfaları listeliyor (OpenAI).
Bir marka bu cevapta üç şekilde yer alabilir. Adı geçebilir: “Türkiye’de X, Y ve Z gibi üreticiler var.” Belirli bir ihtiyaç için önerilebilir: “Köpüren ürünler için X’in dalıcı nozullu modelleri uygun.” Ya da sayfasına link verilerek kaynak gösterilebilir.
Bu üçü birbirinden bağımsız olabiliyor. Köpüren sıvıların nasıl doldurulacağını anlatan rehber yazınız kaynak gösterilirken aynı cevabın öneri listesinde rakipleriniz yer alabilir. Tersi de olur: Markanız önerilir, link ise bir karşılaştırma sitesine ya da bir sektör rehberine gider.
İş sonucu açısından bence en değerlisi önerilmek. 1. bölümde anlattığım gibi müşterilerimizde yapay zekâdan gelen trafik az, ama satışa dönüşme oranı yüksek. Bunun bir sebebi, kullanıcının siteye gelmeden önce yapay zekânın önerisiyle kısa listesini zaten yapmış olması. Kaynak gösterilmek trafik, anılmak bilinirlik getirir; satışı ise çoğu zaman önerilmek getirir. Üçünü ayrı ayrı ölçmeyi 7. bölümde anlatacağım.
6. Aynı soru, farklı cevaplar
Aynı soruyu bir yapay zekâya iki kez sorarsanız büyük ihtimalle iki farklı cevap alırsınız. Model her kelimeyi bir olasılık dağılımından seçerek yazıyor; aynı soruya kelimesi kelimesine aynı cevabı vermesi beklenmiyor. Sorgu yelpazesi de her seferinde aynı çıkmayabiliyor ve farklı alt aramalar farklı sayfaların getirilmesi demek. Arama sonuçları da yerinde durmuyor: Yeni sayfalar dizine giriyor, sıralamalar oynuyor, fiyatlar ve stoklar güncelleniyor.
Bir de bağlam var. Konum, dil, sohbetin önceki mesajları ve modelin kullanıcı hakkında hatırladıkları cevabı etkiliyor. 1. bölümde bahsettiğim Kişisel Zekâ (Personal Intelligence) özelliğiyle Google, izin veren kullanıcılar için Gmail ve Fotoğraflar gibi uygulamalardaki bilgileri de cevaba katabiliyor.
Bu değişkenliğin boyutunu gösteren en iyi çalışmalardan biri SparkToro ve Gumshoe’dan geldi. Rand Fishkin ve Patrick O’Donnell, Kasım ve Aralık 2025’te ChatGPT, Claude ve Google’ın yapay zekâ özelliklerinde 12 farklı öneri sorusunu yüzlerce kez çalıştırdı; toplam 2.961 çalıştırma (Search Engine Journal). Aynı soru için aynı marka listesinin iki kez gelme ihtimali yüzde 1’in altında çıktı. Aynı listenin aynı sırayla gelme ihtimali ise binde 1 civarında.
Buna karşılık bazı markalar çok tutarlı göründü. Katılımcıların kendi kelimeleriyle yazdığı, birbirine hiç benzemeyen kulaklık sorularında Bose, Sony, Sennheiser ve Apple, 994 cevabın yüzde 55 ile 77’sinde yer aldı.
Fishkin, yapay zekâda “sıralama pozisyonu” veren araçlar için “full of baloney”, yani boş laf diyor. Ona göre anlamlı ölçü, çok sayıda çalıştırmada ne sıklıkla göründüğünüz.
Yapay zekâda 1. sıra diye bir şey yok, görünme oranı var. Bir müşteri ChatGPT’ye bir kez sorup markasını göremediğini söylediğinde bu tek başına bir şey anlatmıyor. Aynı niyeti taşıyan farklı soruları farklı platformlarda defalarca sormak ve kaç cevabın kaçında göründüğünüzü saymak gerekiyor. Yöntemini 7. bölümde anlatacağım.
7. Yanlış bilgi de emin bir dille geliyor
Model cevabı kendi cümleleriyle yazdığı için yanlış bir bilgiyi de aynı güvenle yazabiliyor. Ya yanlış ya da eski bir kaynağa dayanıyor, ya da kaynakta olmayan bir bilgiyi kendisi üretiyor. İkincisine halüsinasyon deniyor.
Columbia Üniversitesi’ndeki Tow Center’ın Mart 2025’te yayımladığı çalışma bu riskin boyutunu gösteriyor (Nieman Lab). Araştırmacılar sekiz yapay zekâ arama aracına haber makalelerinden alıntılar verip makalenin başlığını, yayıncısını, tarihini ve adresini sordu; toplam 1.600 sorgu. Araçlar yüzde 60’tan fazla durumda doğru bilgiyi bulamadı. En iyi sonuç yüzde 37 hata oranıyla Perplexity’deydi, en kötüsü yüzde 94 ile Grok 3’teydi. Araçların çoğu yanlışı da emin bir dille söyledi; ChatGPT’nin 134 yanlış cevabından sadece 15’inde bir çekince ifadesi vardı. Bazı araçlar var olmayan linkler üretti.
Çalışma haber kaynakları üzerine yapıldı ve 2025 başındaki araçları ölçtü, bugün sonuçlar farklı olabilir. Markalar için uyarısı ise geçerliliğini koruyor. Yapay zekânın markanız hakkında söylediği her şey doğru olmayabilir.
Markalar için en yaygın riskler eski fiyatlar, kapanmış bir şube ya da değişmiş bir adres, artık üretilmeyen bir ürün, yanlış teknik özellikler ve markanın bir rakiple karıştırılması. 1. bölümde, yapay zekânın sizi önerip yanlış anlattığı durumu en tehlikelisi olarak anmıştım.
Yapılabilecekler:
- Fiyat, adres, çalışma saatleri ve ürün özelliklerini sitenizde tek bir yerde, açıkça ve güncel olarak yazın.
- Kampanyası bitmiş, ürünü kalkmış ya da bilgisi eskimiş sayfaları güncelleyin, yönlendirin ya da kaldırın. 2. bölümde anlattığımız dizinleme kararı burada da geçerli.
- Google İşletme Profili, sektör rehberleri, pazar yerleri ve sosyal medya profillerindeki bilgileri sitenizle aynı hale getirin.
- Markanızı, ürünlerinizi ve fiyatlarınızı farklı platformlarda belirli aralıklarla sorup cevapları kaydedin.
Marka ve üçüncü taraf kaynaklar 13. ve 14. bölümlerde ayrıca ele alınıyor.
8. Zinciri sitenize uygulamak
Yapay zekâ cevabı dışarıdan kara kutu gibi görünse de zinciri takip etmek zor değil: soruyu aramalara böl, sayfaları getir, ilgili parçaları oku, kendi cümlelerinle yaz, kaynak göster. Getirme adımı klasik aramaya dayandığı için 2. bölümdeki temel olmadan geri kalanı çalışmıyor. Alt aramalar yüzünden sayfalarınızın kullanıcının karar verirken soracağı sorulara da cevap vermesi gerekiyor, ama her soru için ayrı sayfa açmadan.
Cevaplar her seferinde değiştiği için tek bir ekran görüntüsüyle karar vermek yanıltıcı. Model markanız hakkında yanlış bir şey söylüyorsa da kaynağı çoğu zaman web’deki eski ya da tutarsız bilgiler.
Bu zincir her platformda aynı malzemeyle kurulmuyor. Google, ChatGPT, Perplexity ve Copilot farklı dizinlerden okuyor ve linki farklı yerlere koyuyor; 4. bölüm bu farklarla ilgili.
Kontrol listesi
| Kontrol | Nasıl bakılır? | Neden önemli? |
|---|---|---|
| Önemli sayfalar ana aramalarda ve ilgili alt aramalarda bulunuyor | Search Console sorguları, elle arama | Model okuyacağı sayfaları aramadan getiriyor |
| Ana ürün ve hizmet sayfaları karar aşamasındaki alt soruları cevaplıyor | Satış ekibinin en sık duyduğu sorularla karşılaştırma | Sorgu yelpazesi alt sorulardan kaynak getiriyor |
| Her alt soru için ayrı sayfa açılmadı | Site haritası ve içerik envanteri | Google bunu ölçekli içerik kötüye kullanımı sayabiliyor |
| Paragraflar bağlamını kendi içinde taşıyor | Bir paragrafı tek başına okumak | Model sayfayı değil parçayı kullanıyor |
| Kapasite, fiyat, süre, bölge gibi bilgiler sayıyla ve açıkça yazılı | Sayfa içeriği | Somut bilgi doğru aktarılıyor |
| Eski fiyat, adres ya da ürün bilgisi içeren sayfa yok | İçerik envanteri, site içi arama | Model eski bilgiyi de güvenle aktarıyor |
| Site dışı profillerdeki bilgiler siteyle aynı | Google İşletme Profili, rehberler, pazar yerleri | Tutarsız bilgi yanlış anlatıma yol açıyor |
| Marka farklı platformlarda ve farklı sorularla düzenli kontrol ediliyor | ChatGPT, Gemini, AI Modu, Copilot, Perplexity | Cevaplar değişken; tek kontrol yanıltıcı |
Kaynaklar
- Google Search Central: Optimizing for generative AI search (son güncelleme 10 Temmuz 2026)
- OpenAI: Introducing ChatGPT search (31 Ekim 2024)
- Search Engine Journal: Query fan-out technique in AI Mode, new details from Google (30 Temmuz 2025)
- Search Engine Land: Google doesn’t want you to create bite-sized chunks of your content (Ocak 2026)
- Search Engine Journal: AI recommendations change with nearly every query (SparkToro) (30 Ocak 2026)
- Nieman Lab: AI search engines fail to produce accurate citations in over 60% of tests (10 Mart 2025)
Önceki: 2. Bölüm, Yapay Zekâ Araması İçin Gereken SEO Temeli · Kitabın dizini · Sonraki: 4. Bölüm, Platformlar Aynı Değil